在纯粹数学的王国里,解安居在实数 的宁静连续统中。我们推导无穷 Taylor 级数、令微元 取极限、书写精确解析根,一切推演皆顺理成章。然而,一旦我们将求解任务托付给由晶体管构成的物理计算机,就必须直面有限硅基世界的刚性约束:实数必须压缩进有限位(如 32 或 64 位)的二进制寄存器,连续的极限过程必须在有限步内截断,无限光滑的函数也只能离散化为网格点上的数组。
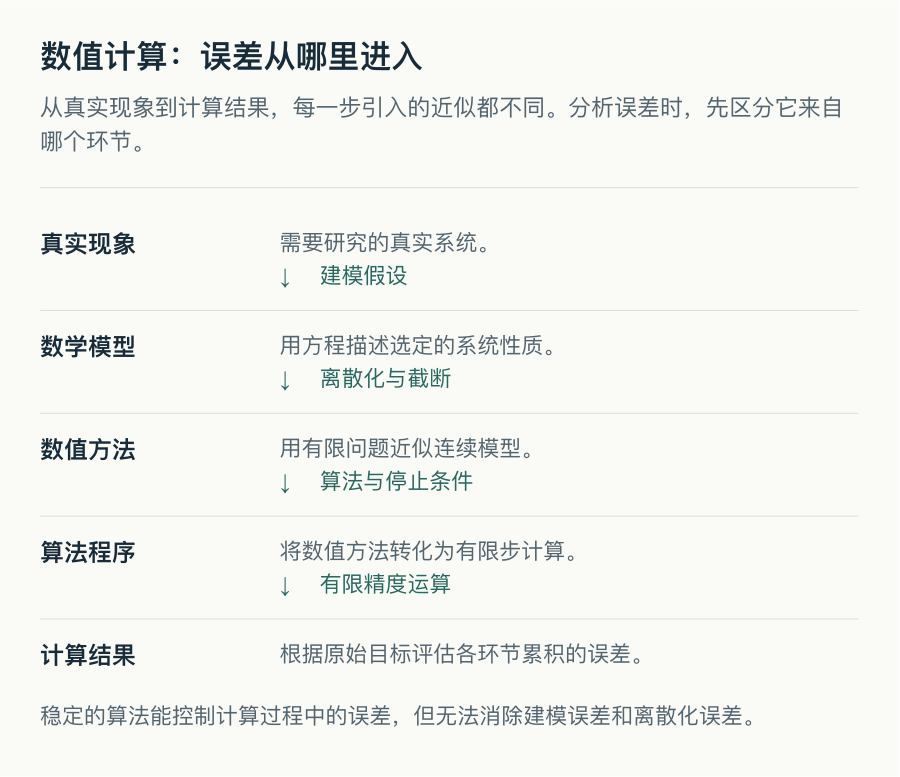
本篇笔记为整个计算数学系列奠定核心词汇与思维模型。在此后的非线性求根、多项式插值与数值微积分中,我们将反复审视衡量算法品质的“四大支柱”:
- 准确性 (Accuracy):输出与数学真解的距离有多近?
- 高效性 (Efficiency):达到目标容差需要消耗多少算力、内存与迭代步数?
- 稳定性 (Stability):算法能否抑制中间舍入与表示扰动的恶性放大?
- 鲁棒性 (Robustness):算法在面对各种边界情形时能否稳定表现,并在假设被破坏时主动报错?
从现象到计算
在敲下第一行代码之前,我们必须厘清物理世界的客观现象是如何一步步进入计算机芯片的。这一链条跨越四个截然不同的层次:物理现象、数学模型、数学问题与离散计算。
数学模型是对客观现象的有意简化。它确定核心变量、参数与物理假设,并建立它们之间的定量关系,从而将现实问题转化为数学表述。
物理学中的守恒定律会催生偏微分方程,机械受力平衡会导出非线性代数方程组。建模阶段决定了什么物理机制被保留、什么细节被舍弃。哪怕我们将方程求解得绝对精确,也无法消除建模误差:基于简化假设的方程,其本身就只是对现实的一种近似描述。
算出十二位有效数字并不意味着结果就真正可信。如果模型本身忽略的空气阻力或热膨胀效应带来了 5% 的物理偏差,那么哪怕把数值算法的误差从 压到 ,也丝毫不会提高对真实世界物理过程的预测精度。
数学问题明确规定允许的输入集合、解必须满足的严格数学条件,以及期望的输出形式。抽象地写,精确解算子可表示为
其中 为输入, 为精确输出。
常见的数学问题包括求非线性方程的根 、计算定积分、解线性代数方程组 或求解微分方程初值问题。一个数学问题若脱离了定义域和前置假设就不完整:解的存在唯一性、函数的光滑度阶数、分母是否非零等约束,与显式写出的公式本身同样关键。
计算是一个有限的执行过程:将已在机器中表示的输入数据,通过允许的基本代数与逻辑操作,转化为已表示的输出数据。它包括数据位级表示、运算顺序、中间量存储以及明确的终止判据。
这一概念将纯数学中的理想映射 与物理机器的实际能力彻底区分开来。实数轴上的点包含不可数的无限信息,而浮点寄存器只有有限的二进制位。因此,计算过程输出的必然是一个离散近似值 ,而非连续的真解 。
公式描述的是静态的数学关系,计算描述的是动态的操作流程。两个实现同一数学公式的程序完全可能输出截然不同的答案,仅仅因为它们重新排列了算术操作顺序,或者触发了不同程度的浮点相消误差。
数值分析是一门专门研究如何为连续数学问题构造离散近似解,并定量分析其误差演化、计算代价、扰动敏感度与算法可靠性的学科。
这门学科追问的绝非仅仅是“机器输出了什么数字”,而是这套逼近是否必定收敛、误差衰减的渐近速率如何、算力开销是否最优,以及算术舍入如何随迭代步演化。
方法、算法与实现
为了在工程实践中精准定位数值缺陷,我们必须严格区分三个层次:数学方法、执行算法与底层实现。
数值方法是用数学语言严谨表述的逼近策略。它通过有限次基础运算,或构造一系列逐步逼近真解的简易子问题,来替代原本无法直接求解的连续问题。
迭代法、离散化、多项式插值、局部线性化与有限差分,都是典型的数值方法。数学描述中必须指明调控逼近精度的参数(如网格步长 、多项式次数 或迭代步数 ),以及误差被保证收敛的数学意义。
数值算法是在特定数据表示格式上实现某个数值方法的有限、确定且可执行的指令序列。它详细规定输入校验、变量初始化、状态更新公式、停机判据、输出格式与错误捕获机制。
同一种数值方法往往能派生出效率与精度迥异的多种算法。例如对 次多项式求值,逐项计算幂次需要 次乘法,而采用 Horner 嵌套乘法仅需 次运算。两者在无穷精度下数学等价,但在算力消耗和舍入误差累积上存在巨大差异。
def numerical_algorithm(data, tolerance, max_steps): state = initialise(data) for step in range(max_steps): new_state = update(state, data) if error_indicator(new_state, state) <= tolerance: return new_state state = new_state raise RuntimeError("requested reliability was not established")这里展现了算法设计的两条黄金法则:停机检验是算法核心逻辑的一部分,绝非可有可无的事后装饰;达到最大迭代步数 max_steps 并非合格的数值结果,而是算法未能证明精度达标的报警信号。
| 层次 | 核心问题 | 典型失效根源 |
|---|---|---|
| 数学问题 | 精确要求是什么? | 问题固有病态或解非唯一 |
| 数值方法 | 采用何种逼近原理? | 截断误差或离散化失真 |
| 数值算法 | 如何有限且安全地执行? | 算法数值不稳定或停机逻辑缺陷 |
| 底层实现 | 硬件上如何具体落地? | 浮点舍入、溢出、下溢或代码缺陷 |
“这个算法能跑通”是一句极其危险的断言。一个关于数学方法的收敛定理,并不能自动保证其浮点实现的数值安全;同样地,一个程序没有崩溃报错,也绝不意味着其底层的数学问题不是病态的。
优秀的数值算法必须满足四项核心品质:
- 准确性 (Accuracy):算法输出与真实数学解的距离在理论上受严格界定;
- 高效性 (Efficiency):以尽可能低的时间与空间复杂度达到给定的误差容限;
- 稳定性 (Stability):能够有效抑制初始扰动与中间算术舍入误差的级联放大;
- 鲁棒性 (Robustness):在整个合法定义域内保持可预测的可靠行为,并在数学前置条件破损时明确报警。
这四项品质始终处于权衡之中。盲目追求快速可能牺牲稳定性,而一个绝对稳定的算法若是应用在高度病态的问题上,输出依然会产生巨大的前向偏差。
四个性质会互相牵连,但不能互相替代。一次测试算得准,并不等于稳定。把稳定方法用在病态问题上,前向误差仍可能很大。鲁棒的方法有时会故意多花工作,去核验假设,或从糟糕初值里恢复。
精度:何谓“接近”
每个数值结果都可能继承来自模型、逼近、机器算术和更早计算步骤的误差。压低其中一种,不会自动压低其余几种。
| 来源 | 原因 | 典型示例 |
|---|---|---|
| 建模误差 | 数学模型省略、简化或误述了物理系统的一部分。 | 模型可能不足以描述病毒传播、复杂电场或光的衍射行为。 |
| 截断误差 | 无穷或连续过程被换成有限计算。 | Newton 法只走 步、Taylor 展开只留有限项、积分只用 个求积节点。 |
| 舍入误差 | 实数和算术运算只用有限浮点精度表示。 | 有效数字有限、相近量相减、以及超出可表示范围的溢出。 |
| 传播误差 | 更早的误差被带进后续步骤,并可能被放大。 | 的前向递推把初始误差乘上越来越大的因子。 |
截断不只出现在 Taylor 级数里。只要算法拥有有限的计算预算,就会产生截断:固定的 Newton 迭代步数、 个求积节点、或间距为 的离散网格。下文给出的 Taylor 余项 是截断误差的一种经典解析形式,其渐近阶揭示了被忽略的部分随 或 加细时的变化规律。
由于计算机仅用有限位浮点数存储实数,任何数据表示与算术操作都伴随着舍入。其中两种实际失真尤为危险:灾难性相消(两个极其接近的数相减导致有效数字急剧丢失)与溢出(中间计算量超出浮点数的表示范围)。后文给出的稳定一元二次方程求解算法,正是规避相消误差的经典范例。
这个交互图需要启用 JavaScript。
定义
分部积分给出前向递推 。记同一递推算出的值为 ,误差 。于是
因此 :初始微小的舍入误差在每一步前向计算中都会被阶乘级放大。这就是典型的误差传播,也说明该递推关系在前向方向上是数值不稳定的。
设 是精确标量, 是算出的近似。绝对误差是
若 ,相对误差是
绝对误差与量本身同单位。相对误差无量纲,把误差拿来和答案的尺度比。两者没有绝对优劣:相对误差在 处没有定义,而当零本身是有意义的参照时,相对误差还可能误导。
| 种类 | 度量什么 |
|---|---|
| 前向误差 | 算出的结果与精确结果的距离:$ |
| 后向误差 | 使 成为某个精确输出的、对输入的最小扰动。 |
| 局部误差 | 假定本步从精确数据出发,单步引入的误差。 |
| 整体误差 | 在整个区间或整段迭代史上累积下来的误差。 |
| 先验界 | 计算前由假设和参数推出的保证。 |
| 后验估计 | 由算出的结果、残差或加密比较得到的估计。 |
残差常常可算,精确误差却常常不可得。对线性方程组, 度量算出的向量满足方程的程度。残差小,只有在问题不太敏感时,才意味着前向误差小。
Taylor 级数与阶
设 在包含 与 的区间上有 阶连续导数。则存在介于 与 之间的点 ,使得
其中以 为中心的 次 Taylor 多项式是
余项(截断误差)是
若 ,余项为零。否则固定 ,令 ,构造
这个函数在 两端为零,且 ()。Rolle 定理先给出两端之间的一个 零点;再在该零点与 之间应用 Rolle 定理,因为 。重复 次,得到内点 满足 。又因 ,所以 ,代回即得余项公式。Rolle 定理的证明见插值误差与 Chebyshev 节点。
记号把逼近来源写清楚了: 是我们实际计算的量, 是丢掉的部分。离开展开点的位移是 。只关心大小时,写 。若 在 附近有界,则 。第一个被丢掉的 的幂,决定了局部逼近阶。
这里 是离开展开点的有符号增量:。本例 ,在 处求值就是在 附近逼近 。把 展到一次,得到
其中 介于 与 之间。先限制 ,于是 。指数函数递增,故
再乘上非负因子 ,得到
若 ,则 ,从而 。若 , 介于 与 之间,于是 ,且 。因此上界在零的两侧都成立:取 ,。近似 的误差在 时是 。
一族逼近是相容的,若局部逼近误差随逼近加细而趋于零。
一个方法是收敛的,若算出的逼近在所声明的极限下趋向精确解,例如 、 或 。
若误差 满足 (当 ),则该逼近至少是 阶的。非正式地说,一旦进入渐近区,把 减半,会把主导误差大约缩小 倍。
在对数坐标上,误差律 呈现为斜率 的直线。双对数图上的直线,只在被测范围内支持渐近误差模型。网格太粗,可能还没进入渐近;加细过头,又可能露出舍入或建模误差。
只报位数、不报误差尺度,是不完整的。更有内容的说法是“,估计相对误差低于 ”,并把估计所依据的假设一并写上。
效率:换精度要花的代价
效率描述达到指定任务或指定精度所需的资源,包括算术运算、函数求值、内存、通信和墙钟时间。
若求一次 就要跑一场大型模拟,函数求值次数往往比标量加法次数更要紧。在现代硬件上,访存和并行通信也可以压过算术代价。
有用的区分包括:运算复杂度、存储复杂度、单步代价与所需步数、收敛速度、工作–精度效率(达到目标误差的总工作量),以及可扩展性。
设一维离散化用 个自由度,代价 ,误差 。要 ,大致需要
这是一条工作–精度定律。提高阶 ,可以大幅降低高精度的代价,前提是高阶方法的常数合理,并且光滑性假设成立。
考虑 。每个幂都单独去算,乘法可以到 。Horner 嵌套形式
只用 次乘法和 次加法,因而是 工作量。方法的数学输出没变,算法组织更好。
def horner(coefficients, x): value = 0.0 for coefficient in reversed(coefficients): value = coefficient + x * value return value衡量效率的核心指标在于“达到目标可信度所需的计算代价”,而非单纯记录单次运行的秒数。一个计算飞快但经常崩溃、或是无法给出误差界限的算法,在实际工程中往往带来高昂的试错与返工成本。
Big-O:共用的语言
当 时,写 ,意思是存在常数 和 ,使得只要 ,就有 。当 时,相应定义要求存在阈值 ,使界对一切 成立。极限制度是陈述的一部分。
Big-O 是“最终被常数倍上界控制”,不是精确值的等式,也不声称两个函数有相同的首项系数。 就算只是松的上界, 仍可以成立。
更紧的分类里, 表示渐近上、下界都有; 表示 ,即 比 渐近地更小。
| 用途 | 极限 | 典型说法 |
|---|---|---|
| 算法代价 | 次运算。 | |
| 离散化误差 | 。 | |
| 迭代误差 | 。 |
语法相同,解读不同。分析代价时,增长越慢越好。误差律 在 时,通常 越大越好,因为误差衰减更快。
若 、(当 ),则
靠近零时,通常较低的幂主导求和。例如 。相消可以提高阶,但必须另证,不能从两个单独的界直接假定。
符号 表示一类有界余项,不是某一个未知标量。从 可以推出 ,但不能把两边的余项当作同一个量划掉。
迭代的阶是后面求根方法的预告,不是第一周的硬性要求。令 。若
且 ,则迭代具有阶 。当 且 时,收敛是线性的; 是二次收敛。这一定义与离散化陈述 不同,尽管都用了“阶”这个词。
Big-O 故意藏起常数,也藏起渐近行为从何时开始。代价为 的方法,在整个实用范围内都可以比 更慢。同样,误差常数很大的 方法,一开始也可能不如 方法准。
稳定性:控制扰动
条件描述数学问题的精确解对输入小扰动有多敏感。相对输入的微小变化就能造成相对输出的巨大变化时,问题是病态的。
对标量映射 ,局部相对条件数在表达式有定义时是 。粗略地,
条件数描述的是问题本身,发生在选定算法之前。输入里已经没有的信息,任何算法都找不回来。
若算法执行过程中引入的扰动,并不显著超出问题条件所不可避免的程度,就称该算法是稳定的。
“不放大误差”作为直觉有用,但需要参照尺度。即使算法稳定,用在病态问题上仍可能出现很大的前向误差,因为精确问题本身就会放大输入的不确定性。
前向稳定性直接限制算出输出与精确输出之差。后向稳定性把算出的输出解释成某个邻近问题的精确解。混合分析在单纯前向或后向不好写时,同时限制输入扰动和输出扰动。后向稳定性之所以有力,是因为它把责任拆开:算法只引入很小的输入扰动,条件数再预言这个扰动如何影响输出。
对 ,教科书公式
在 且 远小于 时,会把几乎相等的数相减。较小的那个根可能丢掉大部分有效数字。稳定的做法是先不算相消地求出较大根,再用 求另一个:
from math import copysign, sqrt
def stable_quadratic_roots(a, b, c):    discriminant = b * b - 4 * a * c    q = -0.5 * (b + copysign(sqrt(discriminant), b))    return q / a, c / q
数学公式没变,经过的中间值变了。这就是稳定性分析的实际用途:找出信息在哪里丢失,再改组计算,让机器去精确求解一个邻近问题。
若一步把误差近似变成 ,反复走下去就是把放大因子连乘。因此稳定性关心的是过程,而不只是一次孤立的算术。上面不稳定的递推,正是这一机制的例子。
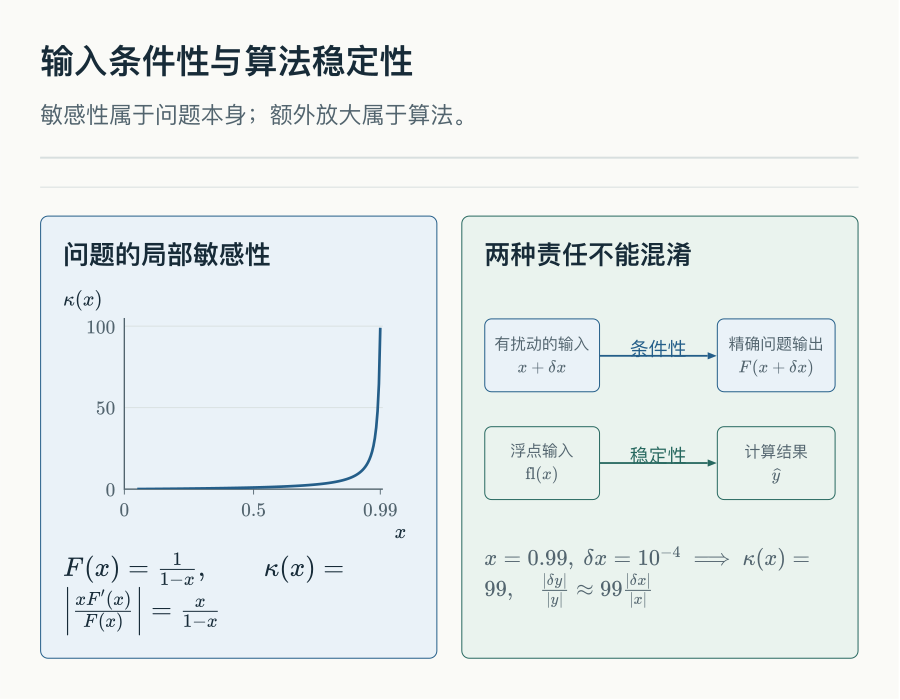
条件性描述问题本身对输入扰动的敏感程度,数值稳定性描述算法计算时是否进一步放大误差。
鲁棒性:在各种情形下仍然可靠
若数值算法在声称的适用范围内,对广泛的可接受输入都能给出可靠结果,并在假设或资源不够时表现可预期(最好带诊断),就称它在该范围内是鲁棒的。
鲁棒性比稳定性更宽。更新公式可以稳定,却仍可能失败:初值落在吸引域外、导数为零、停机检验误导、或中间量超出可表示范围。
有用的维度包括:是否检测非法输入、对初值有多依赖、量级混杂时是否还能工作、靠近困难参数区时表现是否可预期、停机检验能否区分成功与停滞,以及在现有算术下方法是否仍有意义。
鲁棒算法可以组合方法。求根时,带括号的方法能可靠地缩小区间,带导数的一步在根附近可以快得多。混合算法可以在快步仍落在括号内时接受它,否则退回二分。每步多花一点工作,换来更大范围的可信输入。
有用的防护包括:更新前检查定义域和有限值、把变量缩放到可比量级、把绝对与相对容差合在一起用、同时监视残差下降和步长、设置迭代上限并返回明确失败状态,以及进展停滞时换方法。
迭代可能停滞,只因为浮点数已经表示不出一个不同的更新。若停机规则只看 ,这时仍可能报告收敛,即使残差还很大。
把四个性质连在一起的案例
向前差分与中心差分的推导从 Taylor 定理开始:
其中 介于 与 之间。整理得到
因此向前差分是一阶精确的。若 足够光滑,中心差分
的截断误差是 。直觉上人们很容易想把步长 选得极小。但在有限精度的浮点算术中,分子涉及两个相近函数值相减(相消误差),再除以微小的 会急剧放大这些舍入误差。一个简化的总误差模型是
其中 是机器单位舍入(unit round-off)。网格加细会降低截断误差,却不可避免地抬高舍入误差。总误差存在一个最佳的平衡尺度。
这个交互图需要启用 JavaScript。
| 性质 | 这次计算在问什么 |
|---|---|
| 精度 | 离 有多近, 律在多大范围内看得到? |
| 效率 | 达到目标误差需要多少次函数求值和多少精度位? |
| 稳定性 | 相减和除以 会把求值误差放大到什么程度? |
| 鲁棒性 | 过程能否选择或核验 ,察觉停滞,并处理尺度很差的函数? |
通过平衡截断误差与舍入误差两项主导项,该模型导出了最优步长量级 。这远比盲目追求“ 越小越好”深刻得多:它将纯数学的截断分析、有限精度下的数值稳定性与工程参数选择有机统一了起来。
一套可复用的框架
面对新的数值问题,把层次分开:
- 说清问题:输入、想要的输出、定义域、假设,以及有意义的误差尺度。
- 评估条件:数据里的不确定性如何影响精确答案。
- 选择方法:标出逼近参数和收敛假设。
- 设计算法:表示、更新、停机检验、防护和失败状态。
- 把精度、效率、稳定性当成三个分开的问题来分析。
- 在困难的尺度和初值上测鲁棒性,而不只测典型输入。
- 报告近似值时,一并给出残差、误差估计、容差和相关假设。
| 性质 | 主要对象 | 诊断问题 |
|---|---|---|
| 精度 | 输出 | 对既定用途是否足够接近? |
| 效率 | 资源 | 所要求的精度要花多少? |
| 稳定性 | 扰动 | 算法有没有加上本可避免的放大? |
| 鲁棒性 | 工作范围 | 发生失效时能否受控且可被诊断? |
数值分析研究的是从抽象数学问题走向可靠计算结果的完整路径。Big-O 记号串联起了这条路径上的多个核心维度:资源代价的渐近增长、离散逼近误差的衰减速率、以及迭代过程的收敛阶。渐近阶只是算法质量的一个维度;实际常数、问题条件数、浮点稳定性、安全防护机制以及应用场景对结果的具体要求,共同决定了一个数值方法是否真正实用。
评论