最近在复习计算数学,看到求根这一章。讨论数值方法之前,得先确认根一定存在,于是我又把代数基本定理的证明过了一遍。这一次我忽然意识到一件事:这个定理问的是“方程有没有解”,证明却一句方程都没解。它做的事情是在复平面上找 的最低点,再说明最低点的高度只能是 0。
换句话说,这是一个最优化论证。
这篇文章想顺着这个观察往下走:求根和最优化可以互相改写,但改写之后,问题的“地形”会变。代数基本定理之所以成立,归根到底是因为复平面上 的地形好得出奇,除了零点以外没有别的坑。
读这篇文章需要的东西不多:复数的加减乘除、一元函数的导数,再加一点多元微积分里的偏导数。用到复分析的地方,我会先讲直观,再给结论。文中有两个交互实验,可以拖动和点击,建议边读边玩。
先搭好舞台:复平面和“地形”
复数 可以看成平面上的点 ,横轴叫实轴,纵轴叫虚轴。它的模
就是这个点到原点的距离。后面最常用的是复数乘法的几何意义:两个复数相乘,模相乘,辐角(与正实轴的夹角)相加。所以“乘以一个复数”等于“先伸缩,再旋转”。特别地,乘以 就是逆时针转 90 度,这也是 的几何含义:转两次 90 度,正好指向反方向。
一个 次复系数多项式写作
如果 ,就说 是 的根。
每个次数 的复系数多项式至少有一个复数根。
有了一个根 ,就能把 写成 ,再对 重复,所以“至少一个根”推出“恰好 个根(按重数计)”。真正要证明的只有“至少一个”。
现在换个角度看 。对平面上每个点 ,算出一个非负实数 ,把它当成这一点的“高度”。整个复平面就变成了一张地形图:
- 高度永远不小于 0;
- 高度等于 0 的地方,恰好就是根。
于是“ 有没有根”变成了“这张地形图上有没有海拔为 0 的点”。下面这张图就是本文主角 的地形,可以拖动旋转。
这个交互图需要启用 JavaScript。
三个蓝点是三个根,地形在那里降到 0,像三个漏斗。橙色曲线是地形沿实轴的截线,后面会反复用到。
几个最优化的词
在继续之前,先把要用的最优化词汇说清楚。设 是平面上的实值函数。
若对所有 都有 ,称 是 的全局最小点。若只在 的某个小邻域里有 ,称 是局部最小点。
局部最小像山谷里的一个小坑:站在坑底往四周看,哪儿都比脚下高,但翻过山可能还有更深的谷。
梯度。 对两个变量的函数 ,梯度是由两个偏导数组成的向量
它指向 增长最快的方向,长度是那个方向上的增长率。反过来, 就是下坡最陡的方向。梯度下降就是反复沿这个方向走一小步:
其中 是步长。
驻点与鞍点。 梯度为零的点叫驻点,在那里地面是“平”的。光滑函数的局部最小点一定是驻点,因为只要梯度不为零,沿 走一小步就能更低。但驻点不一定是最小点。最典型的反例是
原点处梯度为零。沿 方向看,它是一个坑底;沿 方向看,它是一个坡顶。这样的点叫鞍点,形状像马鞍,也像两座山之间的山口。
最小值一定存在吗? 不一定。 在开区间 上没有最小值,它无限接近 0,却碰不到; 在 上也没有最小值,越往右越低,永远到不了底。前一个例子漏掉了边界,后一个例子跑到了无穷远。把这两种情况排除,结论就成立了:
在有界闭集上连续的函数,一定能取得最小值和最大值。
“闭”保证边界点也算在内,“有界”保证不会一路跑到无穷远。在平面上,闭圆盘 就是有界闭集。
代数基本定理的证明,其实是一个最小化问题
有了这些词,证明可以讲成三步。目标函数取 。
第一步:远处很高。 当 很大时,首项 的模远大于其余各项之和,所以 。优化里管这种性质叫 coercive:越往外走越高,最低点不可能藏在无穷远处。
第二步:最低点存在。 取一个足够大的圆盘,使得圆盘外的高度都超过 。圆盘是有界闭集, 连续,由最值定理,它在圆盘里有最小点 。圆盘外的点都比 高,自然也比 高,所以 是整个复平面上的全局最小点。
第三步:最低点的高度是 0。 这是整个证明的核心,靠的是下面这个引理。
若 不是常数且 ,则在 的任意小邻域里,都存在一点 使 。
换成最优化的话说:不是根的点,一定不是局部最小点。
为什么?把 在 附近展开成 的多项式。设 是第一个系数不为零的正次项:
很小时,更高次项比 小得多,可以先忽略。要让 变小,就要让 这一项把 往原点方向拉,也就是让 指向 的方向。
这一步的关键是复数乘法的几何意义。写 ,那么 的辐角是 , 的辐角是 。想让它等于 的辐角,只要解出 就行,而这总是解得出来的:转角除以 而已。确定了方向,再取足够小的 ,就得到
看一个最简单的例子:,。这里 ,,。要让 指向 ,取 即可,因为 :
如果只允许实数 ,这一步就做不到:实数的平方永远不是负数,。复数多出来的那个维度,正好提供了下坡的方向。这一点后面还会反复出现。
三步合起来:最低点存在,而不是根的点都不可能是最低点,所以最低点就是根。严格的估计(把更高次项控制住)我在复数那篇笔记里写过,这里不再重复。
这条路线有一段曲折的历史。达朗贝尔在 1746 年给出了这个引理,但他默认了最小值存在。高斯 1799 年的博士论文专门批评过包括达朗贝尔在内的早期证明。阿尔冈在 1806 年和 1814 年的工作里用“取 的最小值”把论证组织成今天的样子,柯西 1821 年的《分析教程》也沿用了它。可第二步依赖的最值定理,要等到十九世纪后半叶魏尔斯特拉斯的工作才算真正严格[1][1] H. D. Ebbinghaus, H. Hermes, F. Hirzebruch, M. Koecher, K. Mainzer, J. Neukirch, A. Prestel, and R. Remmert, Numbers. Springer, 1991. Chapter 4, R. Remmert, The Fundamental Theorem of Algebra., [2][2] B. Fine and G. Rosenberger, The Fundamental Theorem of Algebra. Springer, 1997.。也就是说,这个证明里最“分析”的一块,恰好是最优化里最基础的那条存在性定理。
两个方向的改写
一旦这样看,就会发现求根和最优化之间本来就有两座桥。
从求根到最优化。 要解方程组 ,可以去最小化
这里 是向量的长度,,而且 当且仅当 。所以只要最小值等于 0,最小点就是根。系数 只是为了求导后好看。非线性最小二乘、Gauss–Newton 法都从这里出发。
从最优化到求根。 要最小化光滑函数 ,前面说过,局部最小点一定满足
这是一个方程组。费马在十七世纪三十年代就用类似的想法找极值。用 Newton 法做优化,其实就是对梯度 做 Newton 求根。
两座桥都通,但过桥之后,风景不一样。下面用一个具体的多项式来看。
一个例子:实数轴上的假坑
还是那个
它是数值分析课上的老朋友:Newton 法从 0 出发,会在 0 和 1 之间来回跳,永远不收敛。它有一个实根,约为 ,另外两个是共轭复根 。
先只在实数轴上,用“最小化 ”来求根。 在 处为零。记 ,在这一点 取得局部最小值,约为 0.911,不是 0。
这就是一个假坑:它是 的局部最小点,却不是根。在实数轴上做梯度下降,起点只要在 右边,就会滑进这个坑出不来。只在实数里做最优化改写,丢掉了求根问题的本意。
同样的事情在 上更直白:它在实数轴上的最低点是 ,高度为 1,而它根本没有实根。
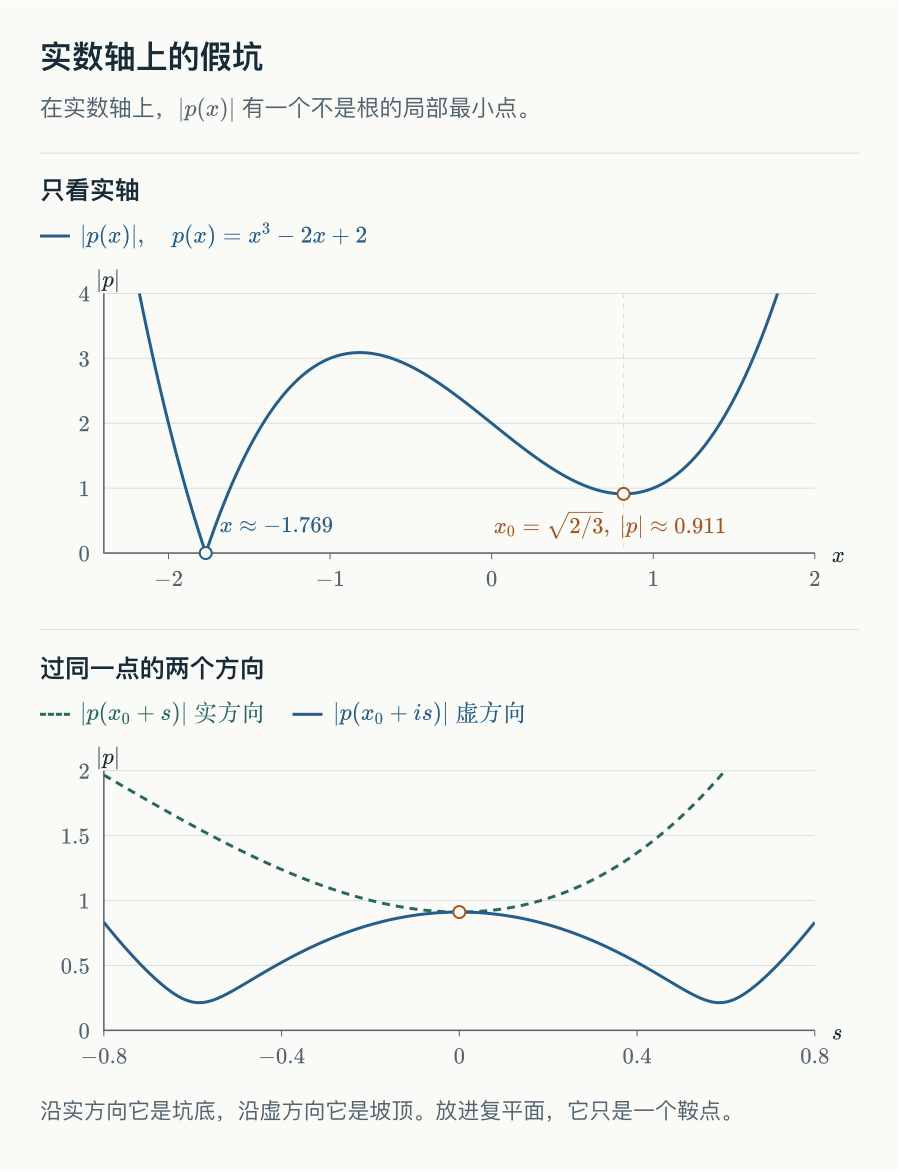
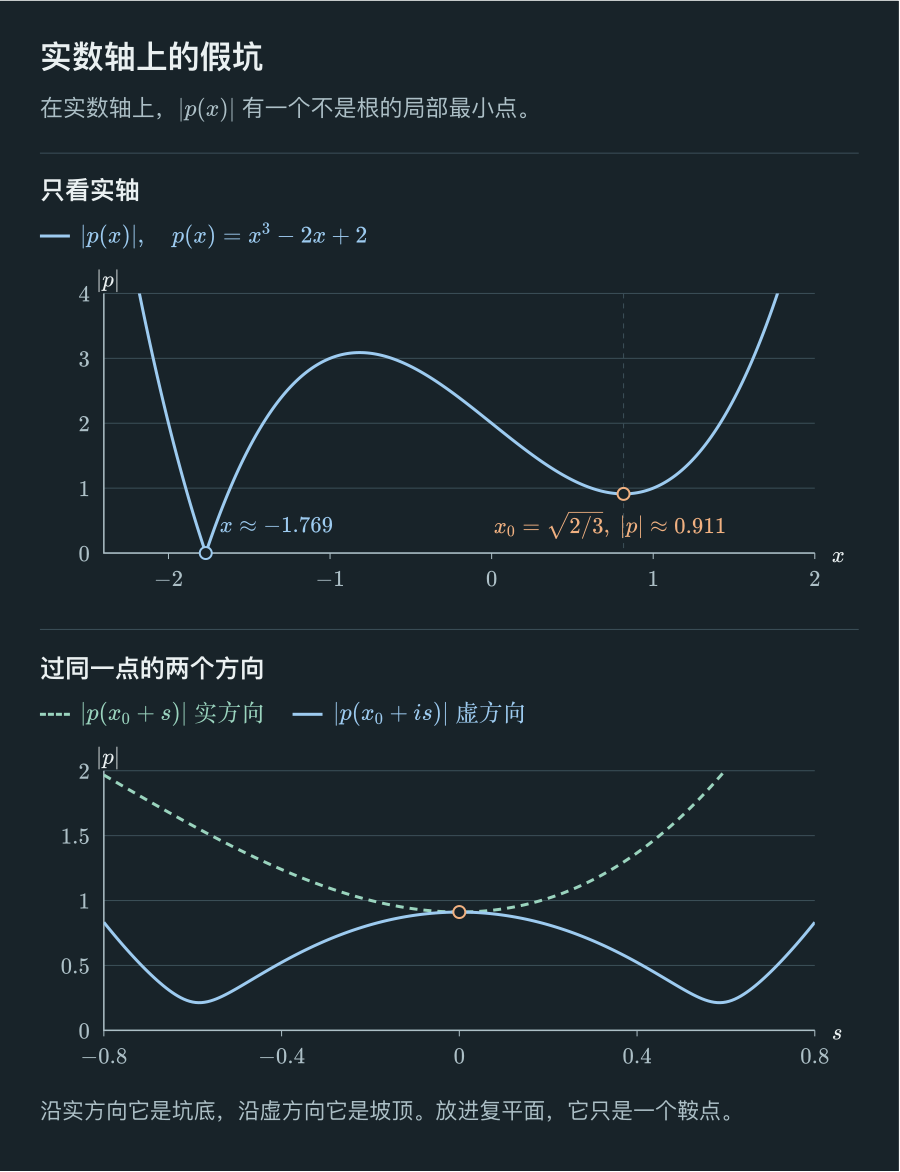
上半张图是实轴上的 :左边是真正的根,右边是假坑。下半张图过同一个点 ,比较沿实方向和沿虚方向走时 的变化,下一节就来解释它。
到了复平面,假坑变成了鞍点
现在把 放进复平面里看。在这一点 ,所以展开式里一次项消失,第一个非零项是二次项:
这正是达朗贝尔引理里 的情形。沿实轴走, 是实数,, 变大,所以在实轴上看它是坑底。可要让 指向负实轴,只需取 为纯虚数。 时,
变小了。
在实数轴上看是坑底,在复平面上看,它只是一个山口:沿实轴方向往上,沿虚轴方向往下,正是前面 那种鞍点。回到上面的三维地形图,点“实轴截面”按钮:曲面沿实轴被切开,正面那条边就是实轴上的曲线,能看到 处的坑。再慢慢拖动旋转,就会发现坑的背后,曲面是往下走的。
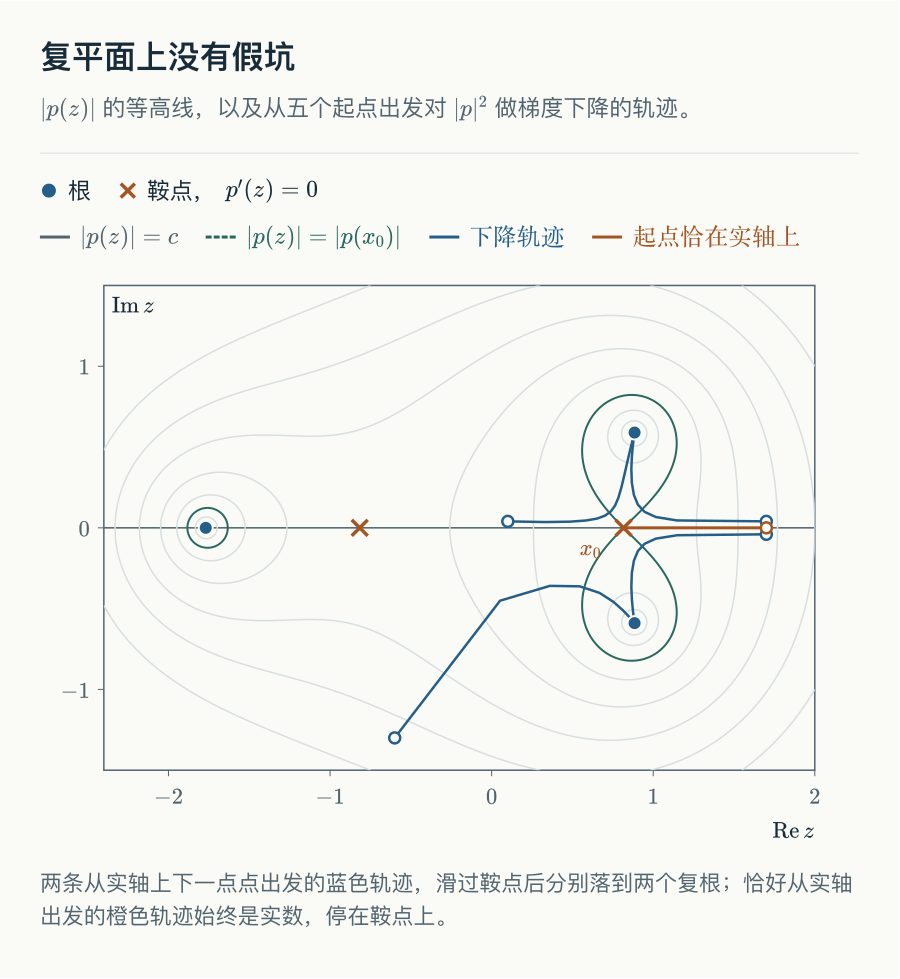
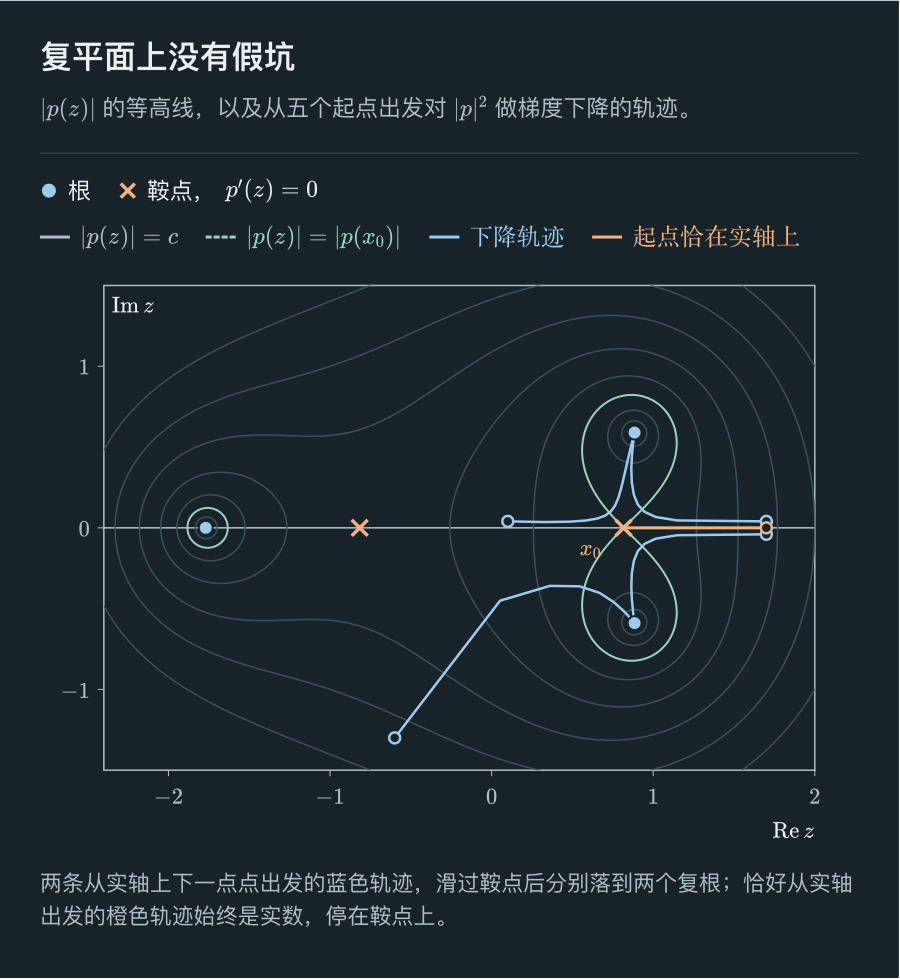
也一样。在 处,要让 指向 ,取 。顺着虚轴往下走,正好走到它的两个根 。
这让我对代数基本定理“为什么一定要在复数里讲”有了更具体的感觉。实数上的反例并不是偶然缺了几个根,而是地形里有坑;复数做的事情,是把每个坑都拆成一个鞍点。
为什么复平面上一个假坑都没有
上一节只看了一个点。要说明复平面上处处如此,需要一个更整体的工具:调和函数。
二元实函数 若满足
就称 是调和函数。
这个条件的直观含义很简单: 方向的弯曲和 方向的弯曲正好相反。如果沿 方向往上弯(二阶导数为正),沿 方向就一定往下弯。而一个严格的局部最小点,需要在每个方向上都往上弯,这和调和条件矛盾。
另一个等价的说法叫平均值性质:调和函数在一点的值,等于它在以这点为圆心的任意小圆周上的平均值。如果某点比周围一圈都低,平均值就不可能等于它,所以调和函数(除非是常数)没有局部最小点,也没有局部最大点。
和本文有关的事实是:在 的地方, 是调和函数。原因是它局部上等于解析函数 的实部,而解析函数的实部都满足上面的方程(这由 Cauchy–Riemann 方程直接推出)。 是递增函数,不改变哪里高、哪里低,所以:
- 在零点以外没有局部最小点。这就是复分析里的最小模原理;
- 的那些不是根的驻点,也就是 而 的点,都只能是鞍点。
拿 验证一下:沿实轴, 的二阶导数是 ,往上弯;调和条件立刻告诉我们,沿虚轴的二阶导数是 ,往下弯。这和上一节的展开完全一致。
从这个角度看,达朗贝尔引理是一个更一般现象的局部版本:非常数的解析函数把每个小邻域映成一个包含 的开集(开映射定理),这个开集里自然有离原点更近的点。
把这件事落到算法上,可以做个实验。 的梯度写成复数形式是
它只在根和 的零点处为零。我在 里随机撒了 2000 个起点,对 做步长 的梯度下降。跑完之后,2000 个起点全部收敛到了三个根之一, 的最大残差在 量级。实数轴上那个让大半起点卡住的坑,在复平面上一个都没留下。
下面这个实验可以自己试:点击平面上任意一点作为起点,看梯度下降怎么走。细线是 的等高线,越靠近根,背景的蓝色越浓;那条 8 字形的虚线是过鞍点 的等高线。
这个交互图需要启用 JavaScript。
推荐试两个预设起点:“1.7” 和 “1.7+0.04i”。只有一种情况会失败:起点恰好落在实轴上。 的系数都是实数,实轴上的梯度也是实数,迭代永远离不开实轴,于是会停在鞍点 。往上或往下偏一点点,轨迹就绕过鞍点,落进复根。随机撒点几乎不可能恰好落在实轴上,这也是 2000 个起点全部成功的原因。
静态图:五条梯度下降轨迹
数值方法里的同一个想法
这层关系在数值方法里一直在用,只是平时不太点破。先简单回顾一下 Newton 法。
Newton 法。 在当前点 用切线近似 :。令右边等于零,解出下一个点
对方程组 ,导数换成 Jacobian 矩阵 ,也就是由所有偏导数 排成的矩阵,Newton 步变成 。Newton 法离根近时收敛极快,离根远时却可能乱跳。
还是 。纯 Newton 法从 0 出发:
看看 的变化:,,再回到 2。从 1 跳回 0 的那一步让 翻了一倍。
价值函数与回溯。 一个自然的补救是给 Newton 法配一把尺子,用它判断“这一步有没有让情况变好”。这把尺子就是前面的 ,在优化里叫价值函数(merit function)。做法是:先试整个 Newton 步;如果 没有下降足够多,就把步长减半再试,直到满意为止。这种做法叫回溯线搜索,配上它的 Newton 法叫阻尼 Newton 法。
它确实打破了循环:从 0 跳到 1, 从 2 降到 1,这一步被接受;从 1 想跳回 0 时, 会翻倍,回溯把步长缩成四分之一,落到 0.75。
但我实际跑下去,出现了新的问题。迭代一步步挤向 0.8165,正是前面那个假坑 。那里 ,Newton 步 的长度趋于无穷,回溯只好把步长缩得越来越小,算法几乎原地不动。它在坑边停了十来步,最后是浮点舍入误差让某一步偶然迈了出去,才落到实根 。这算不上算法的功劳:只要全程用实数算,迭代就离不开实轴,而在实轴上这个坑是真的。
把起点挪到 ,情况完全不同。迭代同样先靠近 ,随后沿虚方向滑下山口,15 步收敛到复根 。价值函数打破了循环,复平面多出来的那个方向化解了假坑。
在上面的实验里把方法换成“阻尼 Newton”或“纯 Newton”,用预设起点 “0” 和 “0.01i” 就能看到这两种结局。状态栏里的“步长比例”是回溯后实际采用的那部分 Newton 步。
静态图:Newton 法的三条路径
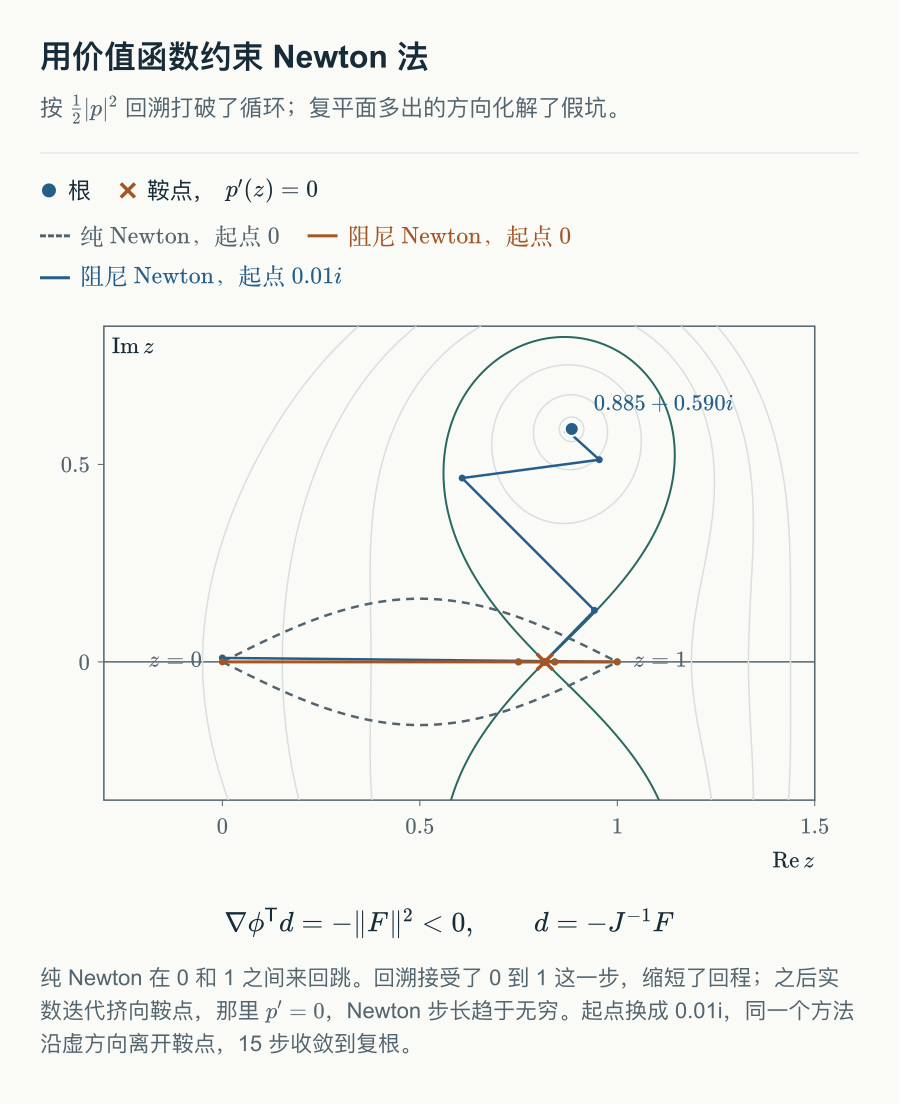
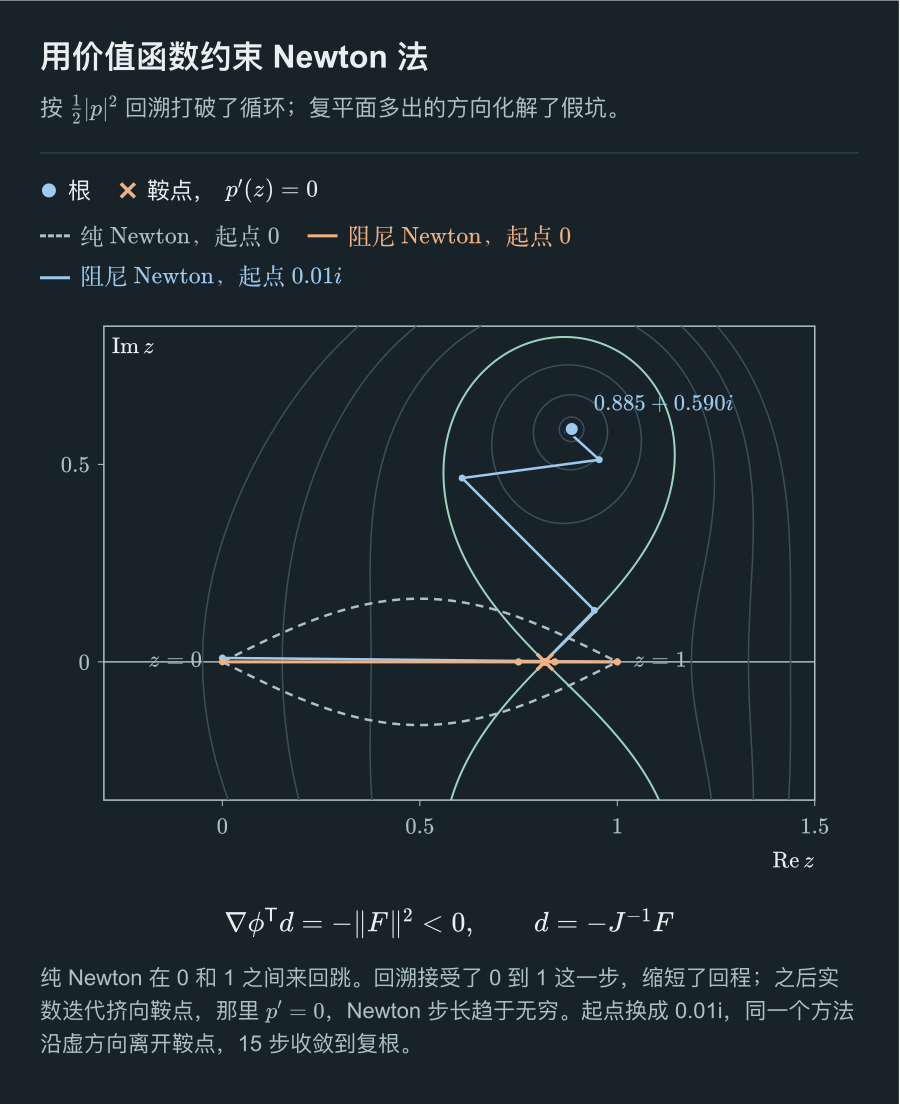
为什么用价值函数来约束 Newton 法是合理的?背后有一个很干净的事实。Newton 方向是 ;价值函数的梯度是 。沿 Newton 方向的方向导数是两者的内积:
只要还没到根,而且 可逆,Newton 方向就一定是 的下坡方向,只是一整步可能迈得太大,回溯负责把它缩短。反过来,这类方法真正会出问题的地方,正是 奇异的点:在那里 Newton 方向失去意义,迭代可能停在一个不是根的点上[3][3] J. Nocedal and S. J. Wright, Numerical Optimization, 2nd ed. Springer, 2006.。上面的 就是这样的点。
求根算法借最优化的尺子来量“有没有变好”,这和达朗贝尔引理的思路一样:不是根,就应该有路往下走。只是高维的方程组没有复平面那么幸运。 可能有真正的假坑,也就是 而 的局部最小点。Gauss–Newton 法和 Levenberg–Marquardt 法卡住的时候,往往就是掉进了这种坑。实数轴上的 ,是这件事最小的模型。
反过来不成立:不是每个求根问题都是最优化
两座桥并不对称。
从最优化到求根,得到的方程组总是某个函数的梯度 。但反过来,一个向量场 要能写成梯度 ,必须满足一个条件。以平面为例,若 ,则
因为光滑函数的混合偏导数与求导顺序无关。换成矩阵的话说, 的 Jacobian 必须对称。在没有“洞”的区域(单连通区域)上,这个条件也是充分的。大多数方程组都不满足这一条,所以求根问题比“找驻点”宽得多。
最简单的反例来自博弈。设想两个玩家:一个控制 ,想让 尽量小;另一个控制 ,想让 尽量大。写成
均衡点是原点:谁单方面改变都占不到便宜。它也是方程组 的根,其中第一个分量 是 对 的偏导数,第二个分量是 对 的偏导数再取负号,因为 玩家在往上走。这个 的 Jacobian 是反对称的,不是任何函数的梯度。
最直接的算法是让两个玩家同时各走一步: 沿梯度下降, 沿梯度上升,叫梯度下降-上升:
这其实是在把点 旋转一个小角度,同时放大 倍。取 从 出发,100 步后到原点的距离变成约 1.64,一圈一圈往外绕。这里没有“地形”可言,也就没有“往下走”。生成对抗网络(GAN)的训练本质上也是这样一个最小最大问题,它那些绕圈和震荡,有一部分原因就在这里。
所以更准确的说法是:最优化可以看成求根的一个特例(梯度场的求根),而求根问题又总能借 改写成最优化,只是改写之后会多出原问题里没有的坑。
回到学习
我对这件事这么在意,一部分原因是它和现在的机器学习理论很像。
最优化里最省心的是凸函数:碗形的函数,局部最小就是全局最小,不会有假坑。可深度学习里的目标函数几乎都不是凸的,理论上随时可能卡在坏的局部最小点,实践中梯度下降却往往表现得很好。过去十年有一条研究线,专门找那些“非凸,但地形良性”的问题:所有局部最小都是全局最小,其余的驻点都是有下坡方向的鞍点。矩阵补全[4][4] R. Ge, J. D. Lee, and T. Ma, “Matrix Completion has No Spurious Local Minimum,” arXiv:1605.07272, 2016. https://arxiv.org/abs/1605.07272、字典学习和相位恢复[5][5] J. Sun, Q. Qu, and J. Wright, “When Are Nonconvex Problems Not Scary?,” arXiv:1510.06096, 2015. https://arxiv.org/abs/1510.06096都被证明属于这一类。再加上“梯度下降几乎不会停在严格鞍点上”这样的结果[6][6] J. D. Lee, M. Simchowitz, M. I. Jordan, and B. Recht, “Gradient Descent Converges to Minimizers,” arXiv:1602.04915, 2016. https://arxiv.org/abs/1602.04915,就能解释为什么简单的算法够用。前面实验里,只有恰好从实轴出发的轨迹会停在鞍点,就是这个结果的一个小例子:实轴在复平面里是一条线,随机起点落上去的概率是 0。
把这些论文的论证结构摊开,和阿尔冈的证明一模一样:目标函数在远处趋于无穷,所以最小值存在;任何不是全局最优的驻点都有下降方向,所以局部最优就是全局最优。
有一处细节反而是代数基本定理更强。机器学习里常要求鞍点是“严格”的:Hessian 矩阵(二阶偏导数组成的矩阵)至少有一个负特征值,也就是至少有一个方向往下弯,靠二阶信息就能找到下坡方向。可达朗贝尔引理里的 可以是 3、4 或者更大。比如 在 处,,那里的二阶导数全是零,像一个“猴鞍”(有三个下坡方向,给猴子的尾巴也留了位置),二阶信息看不出任何下降方向。引理直接用 阶项和 次方根找到了路。对一般函数,处理这种高阶退化的鞍点要难得多,但多项式的结构让它变得很简单。
结语
回头看,代数基本定理这个名字有点误导。它的证明几乎不用代数,用的是两样分析里的东西:有界闭集上的连续函数能取到最小值,以及复数能开 次方。前者保证最低点存在,后者保证最低点之外总有下山的路。
第一次学的时候,我只把它当成“根一定存在”的前提,看完就翻过去了。现在再看,它其实已经把后面要讲的很多事情都预告了:求根可以变成找最低点;找最低点能不能成功,取决于地形里有没有假坑;而好的空间、好的结构,能让假坑消失。
参考文献
- [1] H. D. Ebbinghaus, H. Hermes, F. Hirzebruch, M. Koecher, K. Mainzer, J. Neukirch, A. Prestel, and R. Remmert, Numbers. Springer, 1991. Chapter 4, R. Remmert, The Fundamental Theorem of Algebra. ↩
- [2] B. Fine and G. Rosenberger, The Fundamental Theorem of Algebra. Springer, 1997. ↩
- [3] J. Nocedal and S. J. Wright, Numerical Optimization, 2nd ed. Springer, 2006. ↩
- [4] R. Ge, J. D. Lee, and T. Ma, “Matrix Completion has No Spurious Local Minimum,” arXiv:1605.07272, 2016. https://arxiv.org/abs/1605.07272 ↩
- [5] J. Sun, Q. Qu, and J. Wright, “When Are Nonconvex Problems Not Scary?,” arXiv:1510.06096, 2015. https://arxiv.org/abs/1510.06096 ↩
- [6] J. D. Lee, M. Simchowitz, M. I. Jordan, and B. Recht, “Gradient Descent Converges to Minimizers,” arXiv:1602.04915, 2016. https://arxiv.org/abs/1602.04915 ↩
评论