从方程到迭代
Bellman 方程是一个递归恒等式,是价值函数必须满足的真命题,还不是一个计算它的具体流程。本章补上这一步,而且要补三次:评估一个固定策略、改进一个策略、以及把这两件事压缩成单次回代。
这里的一切都假设环境的动态 P(s′∣s,a) 和 R(s,a) 事先完全已知。这个前提值得开门见山地点名:这是规划(planning),还不是从采样经验中学习。第一章把这条线画成了”基于模型 / 无模型”的分野,而本章完全生活在”模型已知”的那一侧。最后一节会回到这个假设被拿掉之后的情形,那也正是本系列后面部分存在的理由。
有一个想法撑起了下面全部三个算法,值得先说在前面:它们每一个都是某个算子的不动点迭代,而这个算子恰好都是压缩映射。这一点一旦确立,存在性、唯一性和收敛性就会由同一个定理一起交付,后面再也不必重新论证。
策略评估
定义策略评估
给定一个马尔可夫决策过程和一个固定策略 π,策略评估要解决的问题是:为每一个状态计算 Vπ(s)(或 Qπ(s,a))。这是预测问题:这个给定的策略到底有多好?还不是寻找一个更好策略的控制问题。
固定住 π,会让这个 MDP 在马尔可夫阶梯上退回一级:用 π 把动作平均掉之后,一个 MDP 就变成了它所诱导出的马尔可夫奖励过程:
Pπ(s′∣s)=a∑π(a∣s)P(s′∣s,a),Rπ(s)=a∑π(a∣s)R(s,a),
而 Vπ 恰好就是这个诱导出的 MRP 的价值函数。注意到这一点很有用,因为它说明策略评估并不是一个新问题,即它就是上一章里那同一个不动点方程,只不过被限制在了某一个固定策略上。
定义Bellman 期望算子
定义作用在任意函数 V:S→R 上的算子 Tπ:
(TπV)(s)=a∑π(a∣s)[R(s,a)+γs′∑P(s′∣s,a)V(s′)]
Bellman 期望方程,现在变成了一句话:Vπ 是 Tπ 的一个不动点,即 TπVπ=Vπ。把这个方程重新表述成一个算子上的不动点条件,正是让它的”可计算性”变得可以被证明、而不只是显得合理的关键一步。
引理Bellman 期望算子是一个压缩映射
对任意两个函数 V1,V2:S→R,用 sup 范数 ∥V∥∞=maxs∣V(s)∣ 度量距离,有
∥TπV1−TπV2∥∞≤γ∥V1−V2∥∞
证明
对任意状态 s,
(TπV1)(s)−(TπV2)(s)=γa∑π(a∣s)s′∑P(s′∣s,a)(V1(s′)−V2(s′)),因为奖励项 R(s,a) 被抵消了。把每一个差 V1(s′)−V2(s′) 用 ∥V1−V2∥∞ 界住,再把这个界从两层求和里提出来:
(TπV1)(s)−(TπV2)(s)≤γ∥V1−V2∥∞a∑π(a∣s)s′∑P(s′∣s,a).π(⋅∣s) 和 P(⋅∣s,a) 都是概率分布,所以内外两层求和都等于 1,剩下 γ∥V1−V2∥∞。这个界对每一个 s 都成立,所以对左边关于 s 取最大值之后也成立。
算法迭代策略评估
任意初始化 V0。对 k=0,1,2,… 重复:
Vk+1(s)=a∑π(a∣s)[R(s,a)+γs′∑P(s′∣s,a)Vk(s′)]对每一个 s,直到 Vk 不再明显变化为止。上面的引理保证了 Vk→Vπ。
从知道一个策略的价值,到改进它
知道 Vπ 并不等于知道 π 好不好。下一个问题是:如何用 Vπ 得到一个更好的策略?而且很值得注意的是,一个纯粹贪心、只往前看一步的规则就足够了。
定义策略改进
给定 Qπ,相对于它的贪心策略是
π′(s)=argamaxQπ(s,a)
这个贪心策略”不会更差”、并且只要还有改进空间就”严格更好”,这件事本身并不显然,因为 π′ 只用了一步前瞻,而且是针对一个本身就假设”此后永远遵循旧策略 π“的价值函数来定义的。下面这个定理,正是它依然有效的原因。
定理策略改进定理
如果对每一个状态 s 都有 π′(s)=argmaxaQπ(s,a),那么对每一个状态 s 都有 Vπ′(s)≥Vπ(s)。
证明
因为 Vπ(s) 是 Qπ(s,a) 在 a∼π(⋅∣s) 下的一个平均值,它不可能超过 s 处可得的最优动作价值,而按构造,π′(s) 恰好取到了这个最优值:
Vπ(s)≤amaxQπ(s,a)=Qπ(s,π′(s)).用动作价值的 Bellman 方程展开右边,但把动作固定为 π′(s):
Vπ(s)≤R(s,π′(s))+γs′∑P(s′∣s,π′(s))Vπ(s′).同样的不等式 Vπ(x)≤Qπ(x,π′(x)) 在每一个状态 x 处都成立,当然也包括右边出现的每一个 s′。把它代入替换 Vπ(s′),就是把”再往后一步的价值”替换成”再遵循 π′ 走一步得到的奖励,加上一个关于两步之后的、更松的上界”:
Vπ(s)≤Eπ′[Rt+1+γRt+2+γ2Vπ(St+2)∣St=s],这里的期望是对环境的转移取的,而沿途每一个动作都由 π′ 选择。把这个代换归纳地重复 k 次,对任意 k 都有:
Vπ(s)≤Eπ′[i=1∑kγi−1Rt+i+γkVπ(St+k)St=s].假设 Vπ 是有界的(只要奖励有界且 γ<1,这自然成立),那么当 k→∞ 时尾项 γkVπ(St+k)→0。取极限,这个有限的部分和就变成了 π′ 下完整的折扣回报:
Vπ(s)≤Eπ′[Gt∣St=s]=Vπ′(s).
推论没有改进就意味着已经最优
如果策略改进没有产生任何变化,即 π′=π,那么对每一个 s 都有 Vπ(s)=maxaQπ(s,a),这恰好就是 Bellman 最优性方程。由于该方程的解是唯一的,所以 Vπ=V∗,π 就是一个最优策略。
正是这条推论,把”交替进行评估和改进”变成了一个真正带有停止条件的控制算法,而不是一个可能永远循环下去的启发式做法。
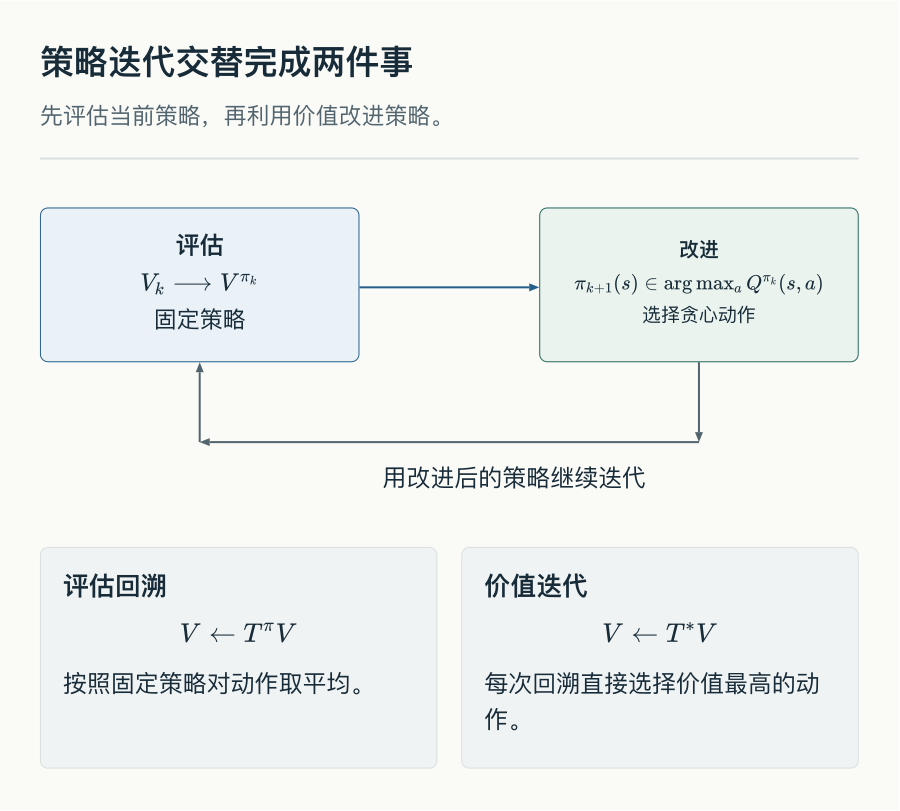
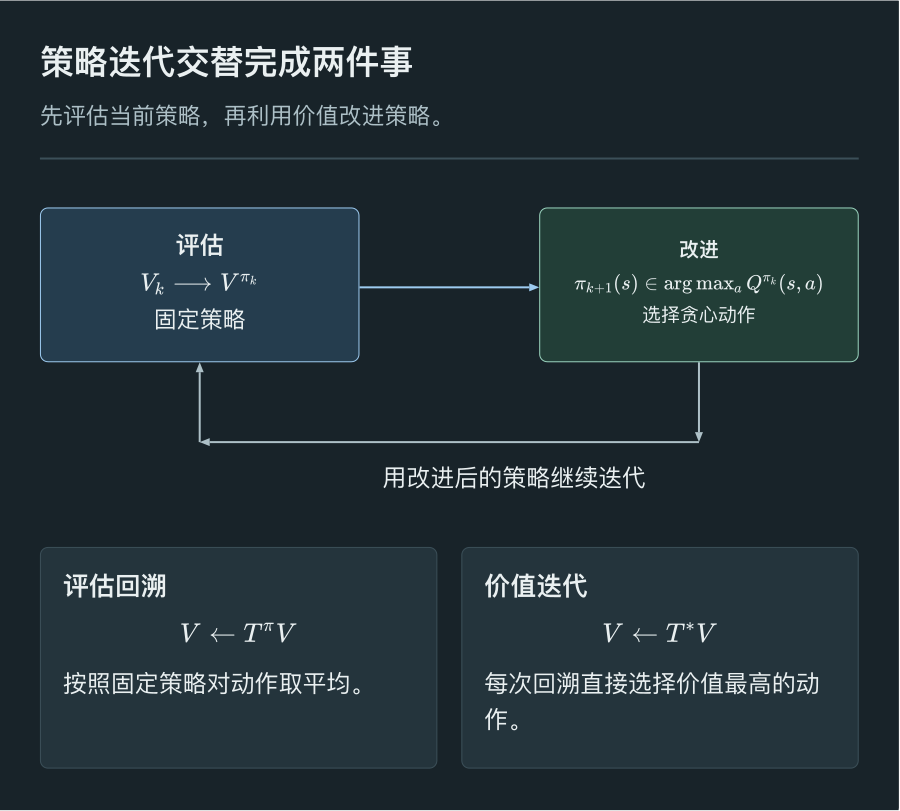
算法策略迭代
任意初始化 π0。对 k=0,1,2,… 重复:
- 评估:计算 Vπk(可以用迭代策略评估,也可以精确求解线性方程组)。
- 改进:对每一个 s,令 πk+1(s)=argmaxaQπk(s,a)。
当 πk+1=πk 时停止;由上面的推论,此时 πk 就是最优的。
这个循环里的每一个中间策略 πk,都是一个真实的、被完整评估过的策略,它本身就是一个有意义的对象,而不只是草稿。而这恰好就是下一节刻意放弃的东西。
策略迭代交替进行评估与改进,价值迭代则在每次回代中直接选择最佳动作。
不等待的最优性回代
策略迭代为了保有干净的中间策略,付出的代价是一个内层循环:每做一次改进之前,都要先让策略评估完全收敛。价值迭代把评估和改进压缩成一次回代,而且直接作用在最优性方程上,而不是期望方程上。
定义Bellman 最优性算子
(T∗V)(s)=amax[R(s,a)+γs′∑P(s′∣s,a)V(s′)]
V∗ 是 T∗ 的不动点,这不过是把 Bellman 最优性方程重新写成 T∗V∗=V∗。要证明 T∗ 也是一个压缩映射,比上面 Tπ 的证明多需要一件工具,因为对动作取 max,不像按 π 加权平均那样是线性的。
引理取最大值不会让差距变得更大
对定义在同一个有限定义域上的任意两个函数 f,g,
amaxf(a)−amaxg(a)≤amax∣f(a)−g(a)∣
证明
设 a∗=argmaxaf(a)。那么
amaxf(a)−amaxg(a)=f(a∗)−amaxg(a)≤f(a∗)−g(a∗)≤amax∣f(a)−g(a)∣,中间一步用到了 maxag(a)≥g(a∗)。交换 f 和 g 的角色,同样可以得到 maxag(a)−maxaf(a) 的界。把两个方向合在一起,就得到了要证明的绝对值不等式。
推论Bellman 最优性算子同样是压缩映射
∥T∗V1−T∗V2∥∞≤γ∥V1−V2∥∞。
证明
固定一个状态 s,把刚证明的引理应用在 f(a)=R(s,a)+γ∑s′P(s′∣s,a)V1(s′) 和 g(a)=R(s,a)+γ∑s′P(s′∣s,a)V2(s′) 上,使得 maxaf(a)=(T∗V1)(s)、maxag(a)=(T∗V2)(s):
(T∗V1)(s)−(T∗V2)(s)=amaxf(a)−amaxg(a)≤amax∣f(a)−g(a)∣.在 f(a)−g(a) 里,奖励项被抵消,对每一个固定的 a 都剩下 f(a)−g(a)=γ∑s′P(s′∣s,a)(V1(s′)−V2(s′)),这恰好就是 Tπ 压缩性证明里被界住的那个量。同样的步骤可以原封不动地照搬过来:用 ∥V1−V2∥∞ 界住每一个 V1(s′)−V2(s′),再用 P(⋅∣s,a) 求和为 1,就得到对每一个 a 都有 ∣f(a)−g(a)∣≤γ∥V1−V2∥∞,从而 maxa∣f(a)−g(a)∣≤γ∥V1−V2∥∞。和第一个不等式结合,就得到对每一个 s 都有 ∣(T∗V1)(s)−(T∗V2)(s)∣≤γ∥V1−V2∥∞,因此在 sup 范数下同样的界也成立。
因为 T∗ 在同一个完备度量空间上也是压缩系数为 γ 的压缩映射,Banach 不动点论证可以原封不动地再用一次:T∗ 有唯一的不动点,并且无论初始猜测是否对应任何一个实际策略的价值,都会以几何速率收敛到这个不动点。
算法价值迭代
任意初始化 V0。对 k=0,1,2,… 重复:
Vk+1(s)=amax[R(s,a)+γs′∑P(s′∣s,a)Vk(s′)]对每一个 s,直到 Vk 不再明显变化;然后提取策略:
π∗(s)=argamax[R(s,a)+γs′∑P(s′∣s,a)V∗(s′)].
这个交互图需要启用 JavaScript。
和策略迭代不同,这个过程中产生的中间量 Vk 不需要等于任何一个策略的价值函数,它们只是被朝着 V∗ 推动的临时规划估计,而不是对智能体当下正在做的某件事的评估。这里的取舍是明确的:策略迭代在每一步都保有一个有意义的策略,代价是一个完整的内层评估循环;价值迭代每个外层步骤只做一次回代,代价是中间的价值在收敛之前本身没有任何意义。
规划不再够用的地方
本章里的每一个方法,都假设转移模型 P(s′∣s,a) 和奖励函数 R(s,a) 是完全已知的。正是这个假设,才使得对下一状态求精确的期望、或者求精确的最大值,成为一个良定义的计算。
一旦这个假设被拿掉,环境必须靠交互和采样去了解、而不能当作一个已知函数去查询,上面这些算法就都不再能直接计算了,因为它们都无法在不知道 P 的情况下求出 ∑s′P(s′∣s,a)(⋅)。注意这次失效有多彻底:不是算法变慢了或者变得不够准,而是每一个算法里都有一项,直接写不出来了。
而这正是基于采样的方法存在的理由:当模型不可用、无法直接拿来回代时,改为从 rollout 中估计同样的那些底层量,即回报与价值。作为概率分布的策略会搭建这类方法所优化的那个对象,策略梯度则推导具体怎么做。
参考资料
- Datawhale Easy RL 第二章
- Bellman, R. (1957). Dynamic Programming. Princeton University Press.
- Sutton, R. S., & Barto, A. G. (2018). Reinforcement Learning: An Introduction (2nd ed.), Chapter 4.
评论