数学设定与可识别的对象
令 为条件输入, 为候选输出。给定 ,策略和参考策略分别是输出空间上的条件分布 与 。本章先按离散空间书写;连续输出时将求和解释为积分、概率解释为对共同基准测度的密度。
以下固定一个全局正则化系数 。在每个 所允许的策略支持集上,还要求 ,并要求后面定义的配分函数有限。支持集条件尤其关键:KL 正则化不允许最优策略在参考策略严格为零的位置凭空放入概率质量,因此 DPO 也无法从参考策略支持集之外“发现”输出。
偏好数据不是确定的真值标签。我们观察到的是带噪声的成对比较 ,其中 表示标注者是否更偏好 。习惯上将样本重排为胜者 与负者 ,把标签吸收进顺序。后面的 logistic 损失是这种随机比较的条件极大似然,而不是把每一条偏好当作不可违背的逻辑公理。
一种通用的偏好学习范式
群体相对策略优化最后建立了一个目标:策略既要提高任务奖励,也不能偏离冻结的参考策略太远。
GRPO 用一条强化学习循环近似优化它:从当前策略采样、给输出评分、估计 advantage,再更新策略。若奖励来自成对偏好,常见路线还要先用偏好对训练奖励模型。这条路线包含两层学习:先学习 ,再用强化学习优化 。
本章的问题更窄:既然手里已经有 这样的偏好对,能否直接优化策略,而不显式训练奖励模型,也不在训练中从策略采样?
Direct Preference Optimization(DPO)给出的答案是可以 [1][1] R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, and C. Finn, “Direct Preference Optimization: Your Language Model Is Secretly a Reward Model,” Advances in Neural Information Processing Systems, vol. 36, 2023. https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html。但它不是凭空把强化学习删掉。它先解开上面的 KL 正则化问题,再发现偏好数据恰好足以把解中的奖励消去。
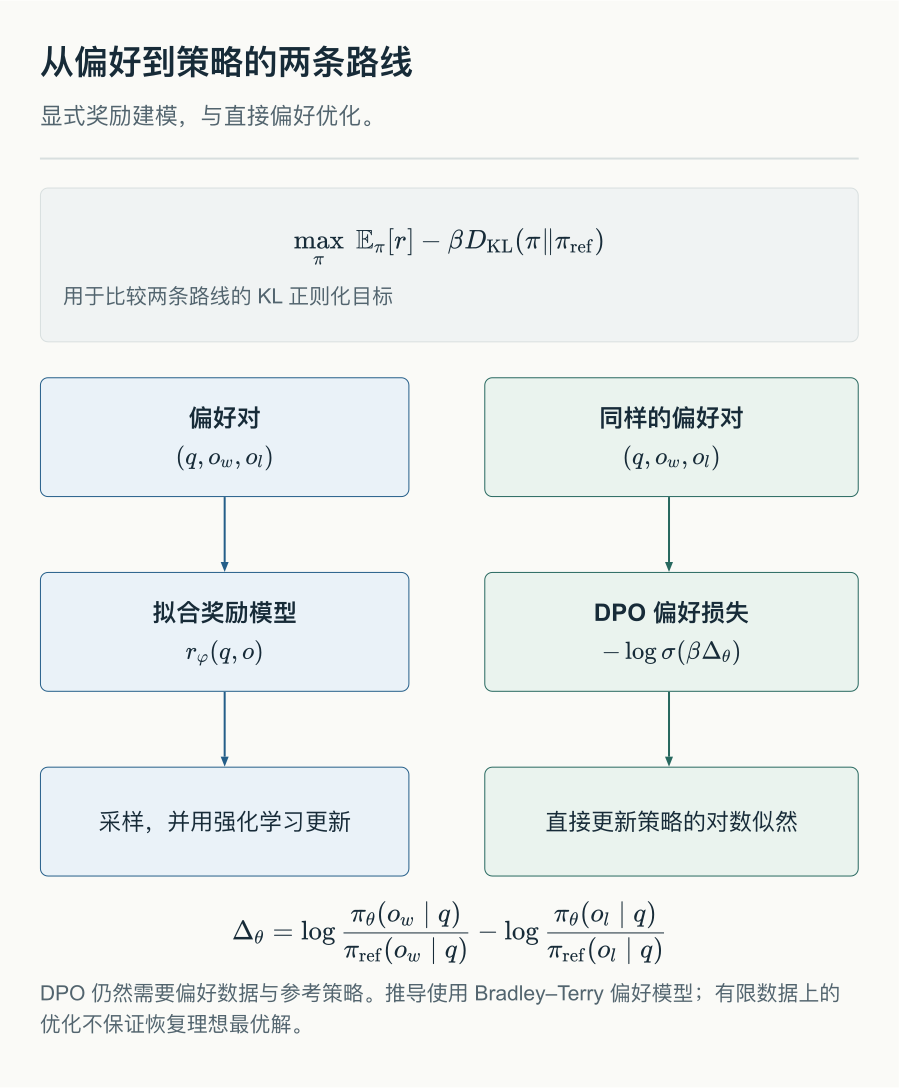
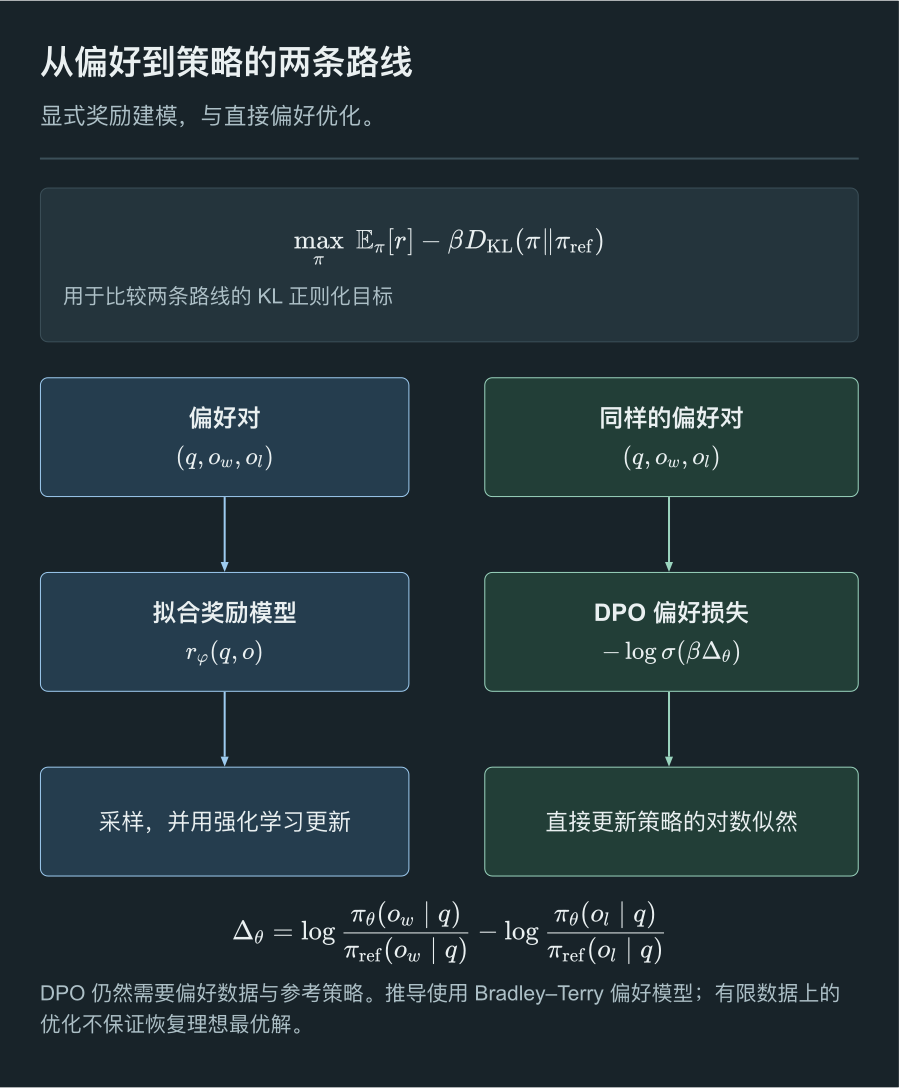
DPO 利用偏好对和参考策略直接更新策略的对数似然,在这条训练路线中省去了单独训练奖励模型的步骤。
两条路线的输入都可以是同一份偏好数据。区别不在于是否假设偏好,而在于是否先把偏好压缩为显式奖励并再进行在线策略优化。
这里的 应读作一般的条件输入, 应读作在该输入下可比较的候选输出。因此 可以是任意神经网络所定义的条件概率分布:文本生成模型、动作策略、候选结构生成器,或其他能够给候选输出赋予概率或密度的模型。DPO 并不专属于语言模型。
不过它也不是对任意确定性网络都能原样套用的损失。推导需要比较 ,因此模型必须定义可计算的条件概率或密度;若网络只输出一个确定值而没有这样的分布,必须先为该任务另行建立概率模型或偏好目标。
先固定一个条件输入
推导的关键是暂时不把所有条件输入混在一起。固定一个 ,将输出空间上的策略简写为 ,参考策略简写为 ,奖励写为 。要解的问题是
并满足 且 当 。这里的 决定奖励与“留在参考策略附近”之间的权衡。
这不是策略梯度问题。暂时把 当作输出空间上可任意选择的概率分布,它只是一个带归一化约束的优化问题。
对固定的 ,若
则上式在参考支持集上严格凹,并有唯一最优策略
其中 是使概率和为一的归一化常数。
给归一化约束引入拉格朗日乘子 。在参考支持集的内部,拉格朗日函数对每个输出 的偏导数为
移项并取指数,得到
最后一个因子与 无关。由 ,它正好是 ,因此得到所述形式。
这不只是驻点。奖励项对 线性,而 在参考支持集上严格凹,故该驻点就是唯一的全局最大值。
这条式子说的不是“奖励越大,输出越可能”这么简单。奖励不会从零开始造出一个新分布;它是在参考策略已有的概率上做指数倾斜。对任意两个输出 ,最优概率比满足
因此,参考概率很小并不意味着有限奖励绝不可能将其反转;结果取决于参考概率比、奖励差和 的共同作用。严格成立的边界只有支持集结论:当参考概率恰为零时,有限奖励无法把该输出带回最优策略。
奖励藏在策略比值里
将上面的最优策略式取对数并整理,得到
这就是 DPO 的核心等式。它把最优策略与一个奖励函数对应起来:只要知道 相对 的对数概率变化,就能恢复与之相容的奖励,差一个只依赖条件输入的常数 。
对同一个 ,给所有输出的奖励同时加上常数,不会改变哪一个策略最优。这个自由度正是 。它不是推导中的漏洞,而是成对偏好数据本来只能识别奖励差的事实。
到这里还没有使用偏好数据。下一步才说明为什么一对“胜出”和“落败”的输出足以消去这个未知常数。
偏好只看差值
对同一个 ,设 是被偏好的输出, 是另一输出。DPO 采用 Bradley-Terry 随机效用模型:条件于两段输出,偏好概率只由潜在奖励差决定:
其中 [2][2] R. A. Bradley and M. E. Terry, “Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons,” Biometrika, vol. 39, no. 3/4, pp. 324–345, 1952. https://doi.org/10.1093/biomet/39.3-4.324。
将奖励的最优策略表达式分别代入 和 ,同一个条件输入对应的 自动相消:
这一步就是 DPO 得以成立的原因。偏好标签并不要求我们知道两个输出各自的绝对奖励;它只要求我们知道哪一个更受偏好。而 KL 正则化最优解中的归一化常数恰好也是逐条件输入的常数,因此在同一偏好对内消失。若偏好不可由单个标量奖励差表达,或不服从 Bradley-Terry 链接函数,这个损失是模型失配的近似,不能由上面的代数自动证明为正确。
从最优策略到可训练模型
真实训练中不知道 ,只拥有参数化模型族 和有限数据集。于是用 替代 Bradley-Terry 模型中原本的 ,并最大化观测偏好对的条件似然。这是一个统计建模与投影步骤,不是把关于真实 的恒等式逐点改写成关于任意 的恒等式。只有在模型族的表达能力足够、偏好模型正确、数据无限且优化达到总体最优时,才会恢复对应的偏好概率。
定义对数比值差
于是得到 DPO 损失:
这只是一个二元分类的负对数似然:模型应当让胜出输出相对于参考策略的概率提升,比落败输出的提升更大。训练时用数据集上的小批量均值近似这个期望。没有显式的 ,也没有从当前策略生成 rollout 的内层循环。
一次更新到底推了什么
将 DPO 的目标写为最大化 。对单个偏好对求梯度:
它有三个部分:
- 第一项提高胜出输出的概率;
- 第二项降低落败输出的概率;
- 决定这一对仍有多少学习信号。若模型已经强烈偏向胜出输出,该系数接近零;若还未学会这项偏好,更新更大。
从更一般的角度看,这是一种加权的条件对数似然梯度:权重不再来自在线采样、奖励评分和 advantage 估计,而是直接由一对离线偏好样本的分类误差给出。若输出由多个局部决策组成,具体模型再将 分解到相应的局部概率上。
β 仍然是 KL 的旋钮
损失中的 不只是 logistic 函数前的温度参数。它来自原始 KL 正则化目标:
在总体模型正确且优化到收敛的意义下,较大的 意味着更强的参考策略约束: 的指数倾斜更弱。它同时放大 DPO 中相对参考策略的对数概率差,因此有限步训练中的梯度尺度也随之变化。不能把某一次训练里梯度更大或更小,直接等同于最终策略必然偏离更多或更少。
若移除 ,DPO 便退化成只让 概率高于 的普通偏好分类。参考模型使“提高胜出答案”变成相对于原模型的变化,并把原始 KL 正则化目标保留在损失中。
DPO 删除了什么,没有删除什么
| 部件 | 奖励模型加 RL 的路线 | DPO |
|---|---|---|
| 成对偏好数据 | 用于训练奖励模型 | 直接用于训练策略 |
| 显式奖励模型 | 需要 | 不需要 |
| 训练中的策略采样 | 需要 | 不需要 |
| critic 与 advantage | 取决于所用 RL 算法 | 不需要 |
| 参考策略 | KL 锚点 | 仍然需要 |
| 偏好假设 | Bradley-Terry 或同类模型 | 仍然需要 |
DPO 删除的是显式的奖励建模和在线强化学习循环,而不是偏好学习本身。它仍需要高质量的偏好对,也仍假设这些偏好能由相对于参考策略的隐式奖励解释。
这也说明它的边界:DPO 在固定偏好数据上优化,不能像在线 RL 那样主动探索当前策略尚未产生过的输出;若偏好数据没有覆盖某种错误或更好的候选,损失本身不会凭空发现它。DPO 的简洁来自把学习信号限定为已有的成对比较,而不是免费获得了更完整的反馈。
应用:语言模型上的 DPO
语言模型只是上述范式的一种具体实例。在这里,条件输入 是 prompt,候选输出 是完整补全;策略 是语言模型对该补全的条件概率。
语言模型的特别之处在于,一个完整补全由 token 序列组成,因此其对数概率可精确分解为
将这个式子代入 DPO 损失后,整对补全给出一个偏好标签,但梯度会分配到每个 token 的条件概率上。这与语言模型中的监督微调形式相同,差别在于:监督微调只提高示范补全的概率,DPO 同时提高胜出补全、降低落败补全,并且两者都相对于参考模型的变化来衡量。
原始 DPO 论文主要在语言模型偏好数据上验证方法 [1][1] R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, and C. Finn, “Direct Preference Optimization: Your Language Model Is Secretly a Reward Model,” Advances in Neural Information Processing Systems, vol. 36, 2023. https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html,这也是 DPO 最常被提及的场景。但推导本身只使用了条件分布、参考策略、KL 正则化与成对偏好模型。换成别的神经概率模型时,改变的是 、 和概率分解方式,不是 DPO 的核心逻辑。
从 GRPO 到 DPO
GRPO 与 DPO 不应被理解成彼此无关的两种技巧。
GRPO 从 KL 正则化目标出发,用采样和 advantage 估计去优化奖励;DPO 从同一目标出发,先解出最优策略的形式,再用偏好对消去奖励和归一化常数。前者适合能够对新输出打分的设置,后者适合已经拥有离线偏好对的设置。
两者真正的分界不是“是否对齐”,而是学习信号在哪里:GRPO 的信号是对当前输出的标量评价,DPO 的信号是预先给定的胜负比较。它们都试图在提高偏好一致性的同时保留参考模型提供的先验行为。
延伸阅读
原论文将 DPO 表述为对 KL 约束奖励最大化问题的直接优化,并在语言模型偏好数据上验证其效果 [1][1] R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, and C. Finn, “Direct Preference Optimization: Your Language Model Is Secretly a Reward Model,” Advances in Neural Information Processing Systems, vol. 36, 2023. https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html。本章首先给出其通用条件分布推导,再把语言模型作为一个应用实例。将 DPO 扩展到 token 级 MDP、在线偏好学习或其他散度形式,需要额外的假设,不能从这一页的推导自动得到。
参考文献
- [1] R. Rafailov, A. Sharma, E. Mitchell, S. Ermon, C. D. Manning, and C. Finn, “Direct Preference Optimization: Your Language Model Is Secretly a Reward Model,” Advances in Neural Information Processing Systems, vol. 36, 2023. https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html a b c
- [2] R. A. Bradley and M. E. Terry, “Rank Analysis of Incomplete Block Designs: I. The Method of Paired Comparisons,” Biometrika, vol. 39, no. 3/4, pp. 324–345, 1952. https://doi.org/10.1093/biomet/39.3-4.324 ↩
评论