大数弱定律
一篇关于大数弱定律、依概率收敛、样本均值,以及 Chebyshev 风格证明方法的基础笔记。
MathematicsProbability TheoryLaw of Large NumbersConvergence
大数弱定律
概览
大数弱定律(Weak Law of Large Numbers, WLLN)描述大量独立同分布随机变量的样本均值会以概率收敛的方式靠近真实均值。
定理大数弱定律
设 X1,X2,…,Xn 是一列独立同分布随机变量,并且
E[Xi]=μ,V(Xi)=σ2<∞.定义样本均值
Xˉn=n1i=1∑nXi.则对任意 ϵ>0,
n→∞limP(∣Xˉn−μ∣≥ϵ)=0.等价地,
XˉnPμ,n→∞.这里的收敛方式称为依概率收敛。
引理Markov 与 Chebyshev 不等式
对非负随机变量 Y 和 a>0,有 P(Y≥a)≤E[Y]/a。因为逐点成立 Y≥a1{Y≥a},取期望即可。再令 Y=(X−E[X])2、a=ϵ2,得到
P(∣X−E[X]∣≥ϵ)≤ϵ2Var(X).
定理讨论的是无限序列 (Xi)i≥1 的前 n 项。有限方差是这里证明采用的条件;只要两两独立且有相同均值与方差,下面的方差计算其实就已成立。
证明使用 Chebyshev 不等式
第 1 步:计算样本均值的期望
E[Xˉn]=E[n1i=1∑nXi]=n1i=1∑nE[Xi]=μ.第 2 步:计算样本均值的方差
由于 Xi 相互独立,
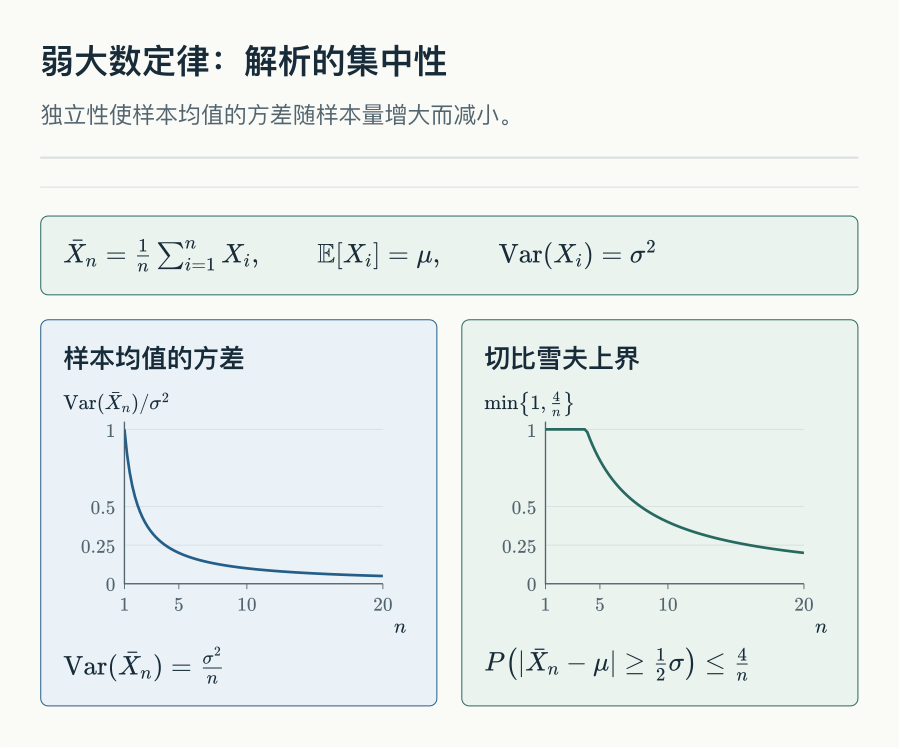
V(Xˉn)=V(n1i=1∑nXi)=n21i=1∑nV(Xi)=nσ2.第 3 步:应用 Chebyshev 不等式
对任意 ϵ>0,
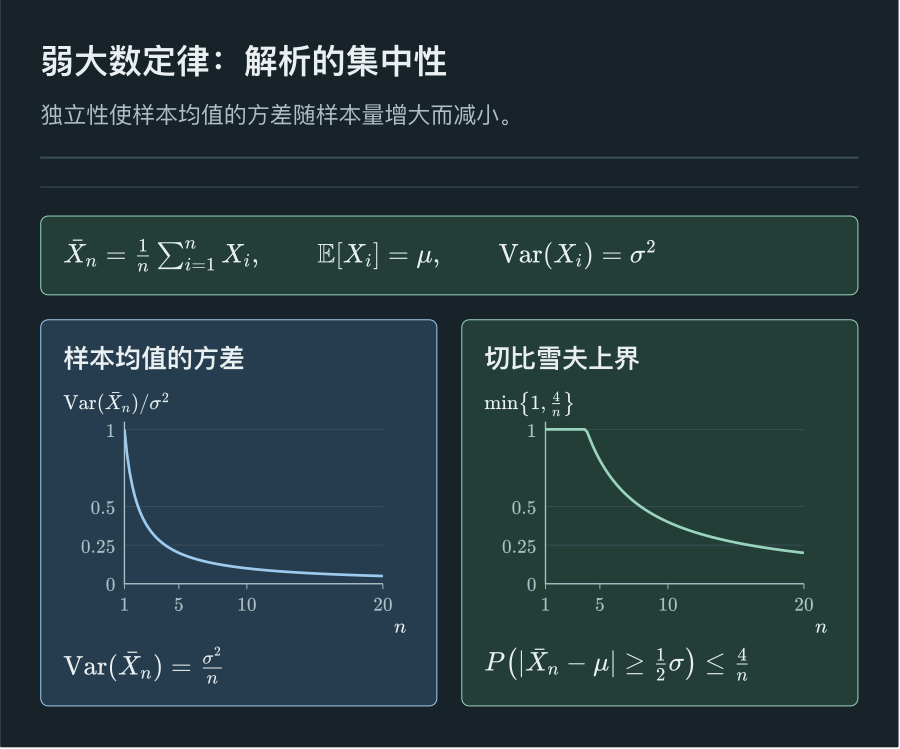
P(∣Xˉn−μ∣≥ϵ)≤ϵ2V(Xˉn)=nϵ2σ2.第 4 步:取极限
n→∞limP(∣Xˉn−μ∣≥ϵ)≤n→∞limnϵ2σ2=0.概率非负,因此该极限只能为 0。
图中画的是样本均值方差与切比雪夫上界的解析曲线,并非模拟得到的样本轨迹。
直观解释
大数弱定律说明,当样本数量足够大时,样本均值 Xˉn 以高概率接近总体均值 μ。它并不是说每一次有限样本都会很接近,而是说偏离任意固定误差 ϵ 的概率会趋于 0。
应用
- 统计估计:解释为什么可以用样本平均估计总体参数。
- 风险池化:保险和风险管理依赖大量独立样本带来的稳定性。
- 质量控制:用样本均值监控生产或系统过程。
- 随机模拟:Monte Carlo 方法依赖样本均值收敛到期望。
与强大数定律的关系
强大数定律(Strong Law of Large Numbers, SLLN)给出几乎处处收敛:
P(n→∞limXˉn=μ)=1.
几乎处处收敛蕴含依概率收敛。固定 ϵ>0,令 BN=⋃n≥N{∣Yn−Y∣≥ϵ}。这些事件随 N 递减;几乎处处收敛说明交集为零概率事件。由概率的上连续性,P(BN)→0。当 n≥N 时,P(∣Yn−Y∣≥ϵ)≤P(BN),所以依概率收敛。
对一般随机变量序列,逆命题不成立。在带均匀概率的 [0,1) 上,把长度为 2−k 的 2k 个二进半开区间的示性函数逐层排列,k=1,2,…。每个函数取一的概率为 2−k,因此依概率趋零;但每个点在每层都落入一个区间,也落在另一个区间外,于是零和一都出现无穷次,逐点极限不存在。这个反例区分的是收敛概念,并不否认本章独立同分布、有限方差的样本均值也满足强大数定律;后者的证明留在尚待撰写的概率极限章节。
例抛硬币
对一枚公平硬币,设第 i 次投掷结果为
Xi={1,0,正面;反面.则 μ=E[Xi]=0.5,σ2=V(Xi)=0.25。
n 次投掷中正面的比例就是 Xˉn。由大数弱定律,
n→∞limP(∣Xˉn−0.5∣≥ϵ)=0.也就是说,投掷次数增加时,正面比例会以概率收敛的方式靠近 0.5。
更多关于期望和方差的内容见期望和方差。
评论