概率分布

概率分布是描述随机变量不同结果可能性的数学函数。它们为随机现象的概率结构提供了完整描述,是统计分析和机器学习的基础。

概述

概率分布可以根据随机变量的性质进行分类:离散(可数结果)、连续(区间内的不可数结果)或混合(组合)。每个分布的特征由其支撑集(可能值)、概率函数(离散为PMF,连续为PDF)、累积分布函数、参数和矩来描述。

定义概率分布

概率分布是函数或规则,它为随机实验的结果或更一般地为样本空间中的事件分配概率。 设 XX 为随机变量,则 XX 的概率分布由其离散变量的概率质量函数(PMF)或连续变量的概率密度函数(PDF)定义。

不失一般性,我们可以将随机变量 XX 的分布定义如下:

P(X=x)=f(x)P(X = x) = f(x)

对于离散变量,其中 f(x)f(x) 是PMF,而

P(X≤x)=F(x)P(X \leq x) = F(x)

对于连续变量,其中 F(x)F(x) 是累积分布函数(CDF)。 PMF和PDF必须满足非负性和归一化性质:

  • 对于离散变量:∑xP(X=x)=1\sum_{x} P(X = x) = 1
  • 对于连续变量:∫−∞∞f(x)dx=1\int_{-\infty}^{\infty} f(x) dx = 1

离散概率分布

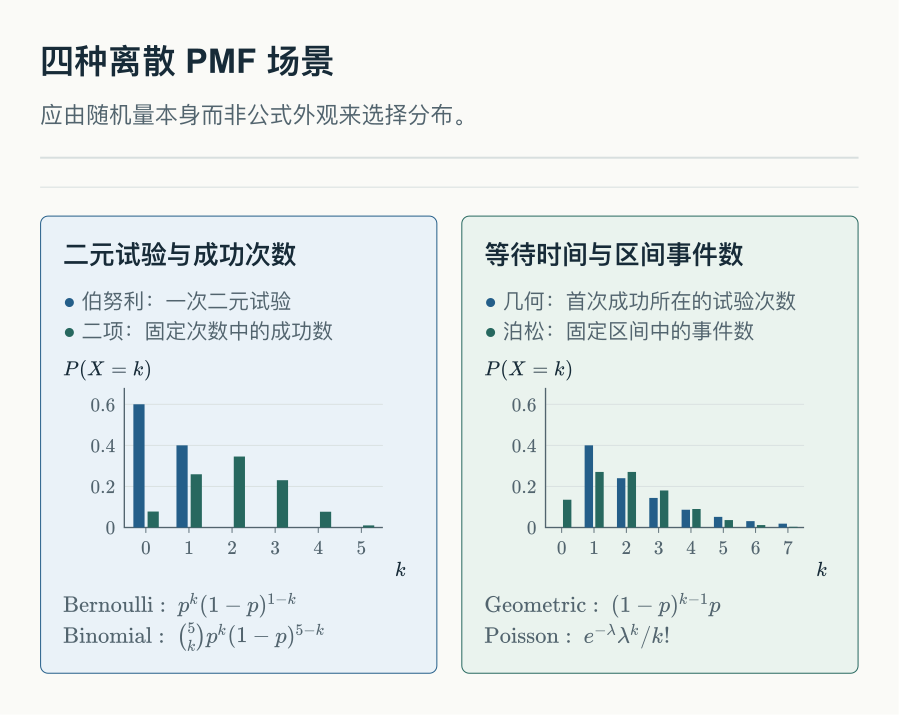
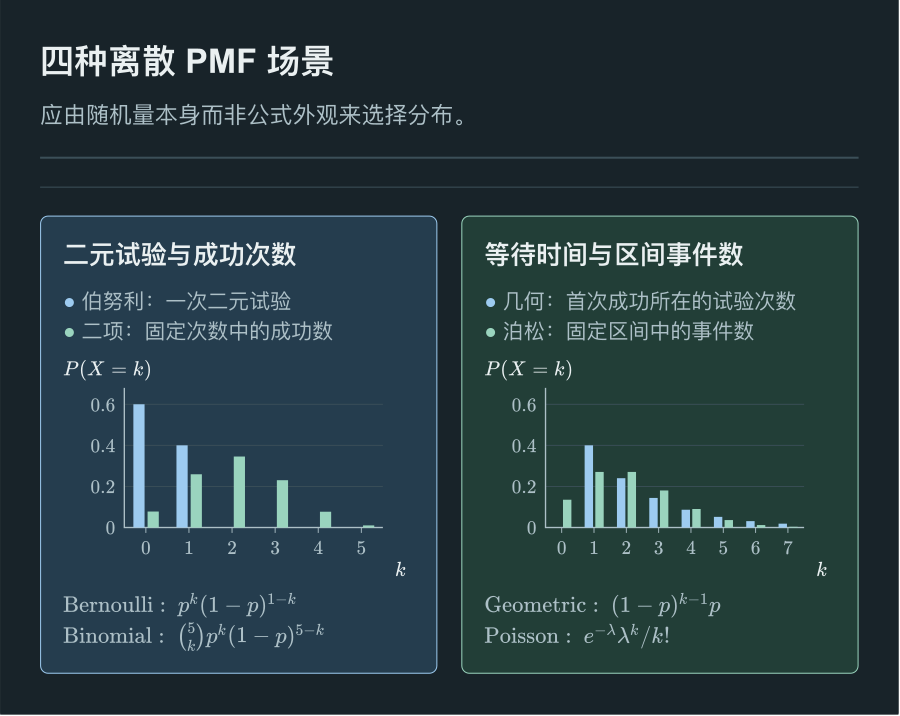
四种离散 PMF 场景。先看随机变量统计的是什么,再区分伯努利、二项、几何与泊松分布。图中参数仅作示例。

四种离散 PMF 场景。先看随机变量统计的是什么,再区分伯努利、二项、几何与泊松分布。图中参数仅作示例。

先看随机变量统计的是什么,再区分伯努利、二项、几何与泊松分布。图中参数仅作示例。

伯努利分布

建模具有两个可能结果(成功/失败)的单次试验

参数:pp(成功概率),其中 0≤p≤10 \leq p \leq 1

支撑集:x∈{0,1}x \in \{0, 1\}

PMF:P(X=x)=px(1−p)1−xP(X = x) = p^x(1-p)^{1-x}

矩计算:

对于期望值:

E[X]=∑x=01x⋅P(X=x)=0⋅(1−p)+1⋅p=p\begin{aligned} \mathbb{E}[X] &= \sum_{x=0}^{1} x \cdot P(X = x) \\ &= 0 \cdot (1-p) + 1 \cdot p \\ &= p \end{aligned}

对于二阶矩:

E[X2]=∑x=01x2⋅P(X=x)=02⋅(1−p)+12⋅p=p\begin{aligned} \mathbb{E}[X^2] &= \sum_{x=0}^{1} x^2 \cdot P(X = x) \\ &= 0^2 \cdot (1-p) + 1^2 \cdot p \\ &= p \end{aligned}

因此,方差为:

V(X)=E[X2]−(E[X])2=p−p2=p(1−p)\begin{aligned} \mathbb{V}(X) &= \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \\ &= p - p^2 \\ &= p(1-p) \end{aligned}

应用:硬币翻转、二元结果、指示变量


二项分布

建模 nn 次独立伯努利试验中的成功次数

参数:nn(试验次数),pp(成功概率)

支撑集:x∈{0,1,2,...,n}x \in \{0, 1, 2, ..., n\}

PMF:P(X=x)=(nx)px(1−p)n−xP(X = x) = \binom{n}{x} p^x(1-p)^{n-x}

矩计算:

期望值可以使用期望的线性性质推导。由于 X=∑i=1nXiX = \sum_{i=1}^{n} X_i,其中 Xi∼伯努利(p)X_i \sim \text{伯努利}(p):

E[X]=E[∑i=1nXi]=∑i=1nE[Xi]=∑i=1np=np\begin{aligned} \mathbb{E}[X] &= \mathbb{E}\left[\sum_{i=1}^{n} X_i\right] \\ &= \sum_{i=1}^{n} \mathbb{E}[X_i] \\ &= \sum_{i=1}^{n} p \\ &= np \end{aligned}

对于方差,由于 XiX_i 是独立的:

V(X)=V(∑i=1nXi)=∑i=1nV(Xi)=∑i=1np(1−p)=np(1−p)\begin{aligned} \mathbb{V}(X) &= \mathbb{V}\left(\sum_{i=1}^{n} X_i\right) \\ &= \sum_{i=1}^{n} \mathbb{V}(X_i) \\ &= \sum_{i=1}^{n} p(1-p) \\ &= np(1-p) \end{aligned}

或者,我们可以直接计算:

E[X]=∑x=0nx(nx)px(1−p)n−x=np∑x=1n(n−1x−1)px−1(1−p)n−x=np\begin{aligned} \mathbb{E}[X] &= \sum_{x=0}^{n} x \binom{n}{x} p^x(1-p)^{n-x} \\ &= np\sum_{x=1}^{n} \binom{n-1}{x-1} p^{x-1}(1-p)^{n-x} \\ &= np \end{aligned}

应用:质量控制、调查抽样、临床试验

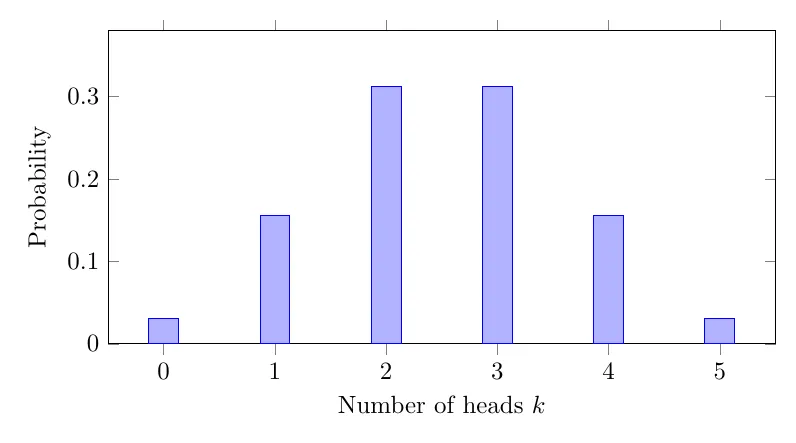
源章节里有一个 n=5n=5 的公平硬币二项分布例子。出现 00 到 55 次正面的概率分别是 132,532,1032,1032,532,132\frac{1}{32},\frac{5}{32},\frac{10}{32},\frac{10}{32},\frac{5}{32},\frac{1}{32}。

二项分布 Binomial(n=5, p=1/2) 的正面次数。


超几何分布

名字看起来像几何分布,其实没有亲戚关系。它得名于出现在概率质量函数里的超几何函数。和伯努利型分布不同,超几何随机变量描写的是无放回抽取,各次抽取彼此依赖。

定义超几何分布

从大小为 NN、其中有 KK 个成功的总体里无放回抽 nn 次,成功次数 kk 服从超几何分布。概率质量函数为

P(X=k)=(Kk)(N−Kn−k)(Nn),max⁡(0,n−(N−K))≤k≤min⁡(K,n).P(X = k) = \frac{\binom{K}{k} \binom{N-K}{n-k}}{\binom{N}{n}}, \quad \max(0, n-(N-K)) \leq k \leq \min(K,n).

组合上看:从 KK 个成功里选 kk 个,从 N−KN-K 个失败里选 n−kn-k 个,再除以从 NN 个里选 nn 个的方法数。

例无放回抽红球

2020 个球里有 88 个红球、1212 个蓝球。无放回抽 55 个。记 XX 为抽到的红球数。则 XX 是参数 N=20N=20、K=8K=8、n=5n=5 的超几何分布,并且

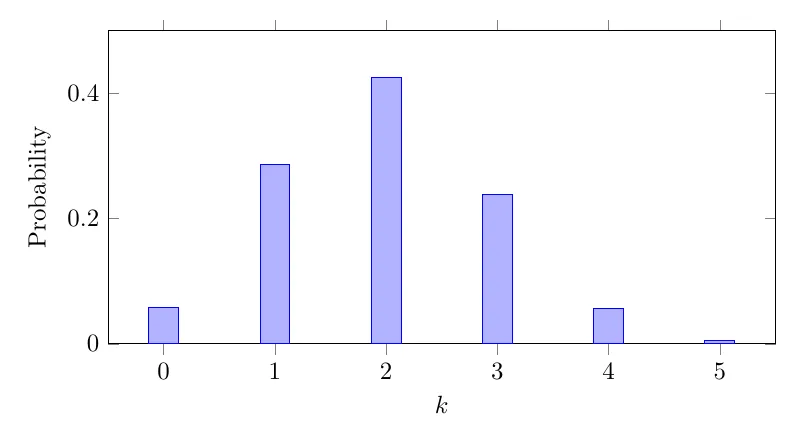
P(X=3)=(83)(122)(205)=56⋅6615504=369615504≈0.2383.P(X=3)=\frac{\binom{8}{3}\binom{12}{2}}{\binom{20}{5}}=\frac{56\cdot 66}{15504}=\frac{3696}{15504}\approx 0.2383.

从 8 红 12 蓝中抽 5 次的超几何分布。

定理超几何分布的期望与方差

设整数参数满足 N>1N>1、0≤K≤N0\le K\le N、0≤n≤N0\le n\le N。若 XX 服从对应的超几何分布,则

E[X]=nKN,Var⁡(X)=nKN(1−KN)N−nN−1.\mathbb{E}[X] = n\frac{K}{N}, \qquad \operatorname{Var}(X) = n\frac{K}{N}\left(1-\frac{K}{N}\right)\frac{N-n}{N-1}.
证明

写 X=∑i=1nIiX=\sum_{i=1}^{n} I_i,其中第 ii 次抽到成功时 Ii=1I_i=1。每个 IiI_i 的期望都是 K/NK/N,线性性给出 E[X]=nK/N\mathbb{E}[X]=nK/N。

二阶矩用 E[X(X−1)]=n(n−1)K(K−1)N(N−1)E[X(X-1)]=n(n-1)\frac{K(K-1)}{N(N-1)},于是

E[X2]=n(n−1)K(K−1)N(N−1)+nKN.E[X^2]=n(n-1)\frac{K(K-1)}{N(N-1)}+n\frac{K}{N}.

减去 (E[X])2(E[X])^2 再整理,就得到方差公式。

令 p=K/Np=K/N,则 Var⁡(X)=np(1−p)N−nN−1\operatorname{Var}(X)=np(1-p)\frac{N-n}{N-1}。当 NN 相对 nn 很大时,多出来的因子接近 11,方差就接近二项分布的 np(1−p)np(1-p)。

应用:无放回抽样、质量控制、生态调查


泊松分布

建模固定区间内发生的事件数量

参数:λ\lambda(率参数),其中 λ>0\lambda > 0

支撑集:x∈{0,1,2,...}x \in \{0, 1, 2, ...\}

PMF:P(X=x)=e−λλxx!P(X = x) = \frac{e^{-\lambda}\lambda^x}{x!}

矩计算:

对于期望值:

E[X]=∑x=0∞x⋅e−λλxx!=e−λ∑x=1∞λx(x−1)!=e−λλ∑x=1∞λx−1(x−1)!\begin{aligned} \mathbb{E}[X] &= \sum_{x=0}^{\infty} x \cdot \frac{e^{-\lambda}\lambda^x}{x!} \\ &= e^{-\lambda}\sum_{x=1}^{\infty} \frac{\lambda^x}{(x-1)!} \\ &= e^{-\lambda}\lambda\sum_{x=1}^{\infty} \frac{\lambda^{x-1}}{(x-1)!} \end{aligned}

令 k=x−1k = x-1:

E[X]=e−λλ∑k=0∞λkk!=e−λλeλ=λ\begin{aligned} \mathbb{E}[X] &= e^{-\lambda}\lambda\sum_{k=0}^{\infty} \frac{\lambda^k}{k!} \\ &= e^{-\lambda}\lambda e^{\lambda} \\ &= \lambda \end{aligned}

对于二阶矩:

E[X2]=∑x=0∞x2⋅e−λλxx!=e−λ∑x=1∞x⋅λx(x−1)!\begin{aligned} \mathbb{E}[X^2] &= \sum_{x=0}^{\infty} x^2 \cdot \frac{e^{-\lambda}\lambda^x}{x!} \\ &= e^{-\lambda}\sum_{x=1}^{\infty} x \cdot \frac{\lambda^x}{(x-1)!} \end{aligned}

令 k=x−1k = x-1:

E[X2]=e−λ∑k=0∞(k+1)⋅λk+1k!=e−λλ∑k=0∞(k+1)⋅λkk!=e−λλ(∑k=0∞k⋅λkk!+∑k=0∞λkk!)=e−λλ(λeλ+eλ)=λ(λ+1)\begin{aligned} \mathbb{E}[X^2] &= e^{-\lambda}\sum_{k=0}^{\infty} (k+1) \cdot \frac{\lambda^{k+1}}{k!} \\ &= e^{-\lambda}\lambda\sum_{k=0}^{\infty} (k+1) \cdot \frac{\lambda^k}{k!} \\ &= e^{-\lambda}\lambda\left(\sum_{k=0}^{\infty} k \cdot \frac{\lambda^k}{k!} + \sum_{k=0}^{\infty} \frac{\lambda^k}{k!}\right) \\ &= e^{-\lambda}\lambda(\lambda e^{\lambda} + e^{\lambda}) \\ &= \lambda(\lambda + 1) \end{aligned}

因此:

V(X)=E[X2]−(E[X])2=λ(λ+1)−λ2=λ\begin{aligned} \mathbb{V}(X) &= \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \\ &= \lambda(\lambda + 1) - \lambda^2 \\ &= \lambda \end{aligned}

性质:泊松分布是二项分布 B(n,p)B(n,p) 当 n→∞n \to \infty,p→0p \to 0 且 np=λnp = \lambda 时的极限。

应用:呼叫中心、交通流量、放射性衰变、稀有事件

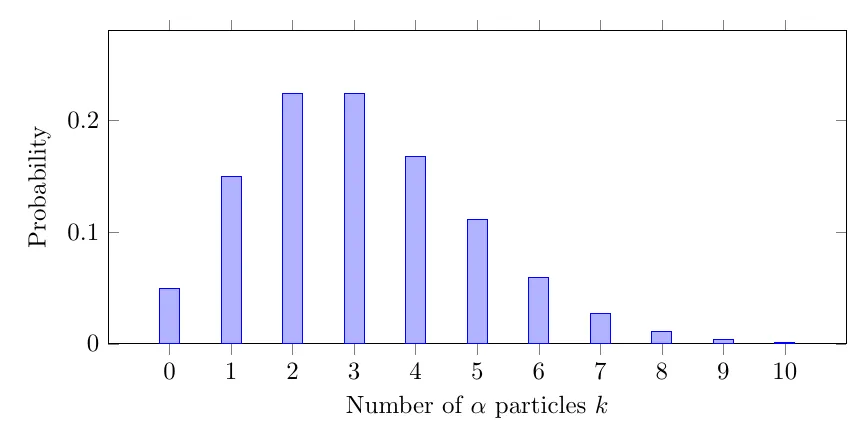
源章节还画了卢瑟福 α\alpha 粒子计数的直方图,下图用的是那里的表列概率。

固定时间间隔内 \alpha 粒子数目的泊松分布。

证明泊松极限

固定非负整数 kk,取 p=λ/np=\lambda/n。当 n≥kn\ge k 且 n>λn>\lambda 时,

(nk)(λ/n)k(1−λ/n)n−k=λkk!∏j=0k−1(1−j/n)(1−λ/n)n(1−λ/n)−k.\binom nk(\lambda/n)^k(1-\lambda/n)^{n-k} =\frac{\lambda^k}{k!}\prod_{j=0}^{k-1}(1-j/n) (1-\lambda/n)^n(1-\lambda/n)^{-k}.

λk/k!\lambda^k/k! 后面的三个因子分别趋于 1,e−λ,11,e^{-\lambda},1,所以每个点概率都趋向泊松 PMF。对有限多个点求和,就得到分布函数在每个有限非整数处的收敛。

几何分布

独立做伯努利试验,每次成功的概率为 pp,一直做到第一次成功。记下这时已经做了多少次,就得到几何分布。

定义几何分布

设 YY 是第一次成功出现时已经进行的试验次数(成功那一次也计入),则 YY 服从参数为 pp 的几何分布。概率质量函数为

P(Y=k)=(1−p)k−1p,k=1,2,3,…P(Y=k)=(1-p)^{k-1}p,\qquad k=1,2,3,\ldots

序列是固定的:k−1k-1 次失败,紧接着一次成功,因此没有二项系数。这些概率构成首项为 pp、公比为 1−p1-p 的几何数列,并且求和为 11:

∑n=1∞P{X=n}=p∑n=1∞(1−p)n−1=p1−(1−p)=1.\sum_{n=1}^{\infty}P\{X=n\}=p\sum_{n=1}^{\infty}(1-p)^{n-1}=\frac{p}{1-(1-p)}=1.
例第一次罚中

一名篮球运动员罚球命中的概率是 p=0.3p=0.3。第一次命中出现在第 44 次出手的概率是多少?

解

设 XX 为第一次命中时的出手序号。则

P(X=4)=(0.7)3⋅0.3=0.1029.P(X=4)=(0.7)^3\cdot 0.3=0.1029.
定理几何分布的期望与方差

若 XX 服从参数为 pp 的几何分布,则

E[X]=1p,Var⁡(X)=1−pp2.\mathbb{E}[X]=\frac{1}{p},\qquad \operatorname{Var}(X)=\frac{1-p}{p^2}.
证明

先设 0<p<10<p<1,令 q=1−pq=1-p。由比值判别,kqk−1kq^{k-1} 与 k2qk−1k^2q^{k-1} 的级数收敛,所以下面的期望有限,可以重排。按第一次试验分类:失败后 X=1+X′X=1+X',其中 X′X' 与原来的几何变量同分布。记 m=E[X]m=E[X]、s=E[X2]s=E[X^2],则

m=p+q(1+m)=1+qm,m=p+q(1+m)=1+qm,

故 m=1/pm=1/p。再对平方做完整展开:

s=p+q(1+2m+s)=1+2qm+qs.s=p+q(1+2m+s)=1+2qm+qs.

于是 s=(1+2q/p)/p=(2−p)/p2s=(1+2q/p)/p=(2-p)/p^2,减去 m2m^2 即得方差 (1−p)/p2(1-p)/p^2。若 p=1p=1,则 X=1X=1 几乎处处成立,公式仍适用;p=0p=0 时没有有限等待时间,必须排除。

其他离散分布

本节待撰写 / 占位标记

源讲义在提纲中列举了若干进阶离散分布族:离散均匀分布、负二项分布、Zeta-Bernoulli 分布、对数级数分布与 Zipf 分布。完整的定义、PMF 表达与矩计算公式已列入后续撰写队列。

连续概率分布

正态(高斯)分布

统计学中最重要的连续分布

参数:μ\mu(均值),σ2\sigma^2(方差)

支撑集:x∈(−∞,∞)x \in (-\infty, \infty)

PDF:f(x)=1σ2πe−(x−μ)22σ2f(x) = \frac{1}{\sigma\sqrt{2\pi}} e^{-\frac{(x-\mu)^2}{2\sigma^2}}

矩计算:

对于标准正态分布 Z∼N(0,1)Z \sim N(0,1):

期望值为:

E[Z]=∫−∞∞z⋅12πe−z2/2dz=0\begin{aligned} \mathbb{E}[Z] &= \int_{-\infty}^{\infty} z \cdot \frac{1}{\sqrt{2\pi}} e^{-z^2/2} dz \\ &= 0 \end{aligned}

这是因为被积函数是奇函数且积分收敛。

对于方差:

E[Z2]=∫−∞∞z2⋅12πe−z2/2dz\begin{aligned} \mathbb{E}[Z^2] &= \int_{-\infty}^{\infty} z^2 \cdot \frac{1}{\sqrt{2\pi}} e^{-z^2/2} dz \end{aligned}

使用分部积分,设 u=zu = z,dv=ze−z2/2dzdv = z e^{-z^2/2} dz:

E[Z2]=12π[−ze−z2/2]−∞∞+12π∫−∞∞e−z2/2dz=0+1=1\begin{aligned} \mathbb{E}[Z^2] &= \frac{1}{\sqrt{2\pi}} \left[ -z e^{-z^2/2} \right]_{-\infty}^{\infty} + \frac{1}{\sqrt{2\pi}} \int_{-\infty}^{\infty} e^{-z^2/2} dz \\ &= 0 + 1 \\ &= 1 \end{aligned}

因此,V(Z)=E[Z2]−(E[Z])2=1−0=1\mathbb{V}(Z) = \mathbb{E}[Z^2] - (\mathbb{E}[Z])^2 = 1 - 0 = 1。

对于一般正态分布 X=μ+σZX = \mu + \sigma Z:

E[X]=E[μ+σZ]=μ+σE[Z]=μ\begin{aligned} \mathbb{E}[X] &= \mathbb{E}[\mu + \sigma Z] \\ &= \mu + \sigma \mathbb{E}[Z] \\ &= \mu \end{aligned} V(X)=V[μ+σZ]=σ2V(Z)=σ2\begin{aligned} \mathbb{V}(X) &= \mathbb{V}[\mu + \sigma Z] \\ &= \sigma^2 \mathbb{V}(Z) \\ &= \sigma^2 \end{aligned}

条件:相互独立的正态变量的线性组合仍为正态,可反复应用下证与仿射变换公式得到;只有各边缘分布为正态并不够。独立同分布的中心极限定理讨论的是中心化后再除以 σn\sigma\sqrt n 的和,要求有限正方差;其一般证明属于尚待撰写的概率极限章节。

可加性性质:如果 X∼N(μ1,σ12)X \sim N(\mu_1, \sigma_1^2) 和 Y∼N(μ2,σ22)Y \sim N(\mu_2, \sigma_2^2) 独立,则:

X+Y∼N(μ1+μ2,σ12+σ22)X + Y \sim N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2)
证明可加性

独立性给出卷积密度 fX+Y(z)=∫fX(x)fY(z−x) dxf_{X+Y}(z)=\int f_X(x)f_Y(z-x)\,dx:先在 x+y≤zx+y\le z 上积分联合密度,再对 zz 求导即可。记 v=σ12+σ22v=\sigma_1^2+\sigma_2^2,并令

mz=σ22μ1+σ12(z−μ2)v.m_z=\frac{\sigma_2^2\mu_1+\sigma_1^2(z-\mu_2)}{v}.

配方得到

(x−μ1)2σ12+(z−x−μ2)2σ22=v(x−mz)2σ12σ22+(z−μ1−μ2)2v.\frac{(x-\mu_1)^2}{\sigma_1^2} +\frac{(z-x-\mu_2)^2}{\sigma_2^2} =\frac{v(x-m_z)^2}{\sigma_1^2\sigma_2^2} +\frac{(z-\mu_1-\mu_2)^2}{v}.

第一个高斯因子的积分为 2πσ1σ2/v\sqrt{2\pi}\sigma_1\sigma_2/\sqrt v,连同原来两个密度的归一化因子,留下

fX+Y(z)=12πvexp⁡(−(z−μ1−μ2)22v),f_{X+Y}(z)=\frac1{\sqrt{2\pi v}} \exp\left(-\frac{(z-\mu_1-\mu_2)^2}{2v}\right),

正是所求正态密度。若某个方差为零,对应变量为常量,直接平移便得到结论。

证明使用矩生成函数

X∼N(μ,σ2)X \sim N(\mu, \sigma^2) 的矩生成函数为:

MX(t)=eμt+12σ2t2M_X(t) = e^{\mu t + \frac{1}{2}\sigma^2 t^2}

对于独立的 XX 和 YY:

MX+Y(t)=MX(t)⋅MY(t)=eμ1t+12σ12t2⋅eμ2t+12σ22t2=e(μ1+μ2)t+12(σ12+σ22)t2M_{X+Y}(t) = M_X(t) \cdot M_Y(t) = e^{\mu_1 t + \frac{1}{2}\sigma_1^2 t^2} \cdot e^{\mu_2 t + \frac{1}{2}\sigma_2^2 t^2} = e^{(\mu_1 + \mu_2)t + \frac{1}{2}(\sigma_1^2 + \sigma_2^2)t^2}

这是 N(μ1+μ2,σ12+σ22)N(\mu_1 + \mu_2, \sigma_1^2 + \sigma_2^2) 的矩生成函数,证明了结果。

应用:自然现象、测量误差、统计推断


指数分布

建模泊松过程中事件之间的时间

参数:λ\lambda(率参数),其中 λ>0\lambda > 0

支撑集:x∈[0,∞)x \in [0, \infty)

PDF:f(x)=λe−λxf(x) = \lambda e^{-\lambda x} 对于 x≥0x \geq 0

矩计算:

对于期望值:

E[X]=∫0∞xλe−λxdx\begin{aligned} \mathbb{E}[X] &= \int_{0}^{\infty} x \lambda e^{-\lambda x} dx \end{aligned}

使用分部积分,设 u=xu = x,dv=λe−λxdxdv = \lambda e^{-\lambda x} dx:

E[X]=[−xe−λx]0∞+∫0∞e−λxdx=0+[−1λe−λx]0∞=1λ\begin{aligned} \mathbb{E}[X] &= \left[ -x e^{-\lambda x} \right]_{0}^{\infty} + \int_{0}^{\infty} e^{-\lambda x} dx \\ &= 0 + \left[ -\frac{1}{\lambda} e^{-\lambda x} \right]_{0}^{\infty} \\ &= \frac{1}{\lambda} \end{aligned}

对于二阶矩:

E[X2]=∫0∞x2λe−λxdx\begin{aligned} \mathbb{E}[X^2] &= \int_{0}^{\infty} x^2 \lambda e^{-\lambda x} dx \end{aligned}

使用分部积分,设 u=x2u = x^2,dv=λe−λxdxdv = \lambda e^{-\lambda x} dx:

E[X2]=[−x2e−λx]0∞+∫0∞2xe−λxdx=0+2λ∫0∞xλe−λxdx=2λ⋅1λ=2λ2\begin{aligned} \mathbb{E}[X^2] &= \left[ -x^2 e^{-\lambda x} \right]_{0}^{\infty} + \int_{0}^{\infty} 2x e^{-\lambda x} dx \\ &= 0 + \frac{2}{\lambda} \int_{0}^{\infty} x \lambda e^{-\lambda x} dx \\ &= \frac{2}{\lambda} \cdot \frac{1}{\lambda} \\ &= \frac{2}{\lambda^2} \end{aligned}

因此:

V(X)=E[X2]−(E[X])2=2λ2−(1λ)2=1λ2\begin{aligned} \mathbb{V}(X) &= \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \\ &= \frac{2}{\lambda^2} - \left(\frac{1}{\lambda}\right)^2 \\ &= \frac{1}{\lambda^2} \end{aligned}

性质:无记忆性:P(X>s+t∣X>s)=P(X>t)P(X > s+t | X > s) = P(X > t)

应用:可靠性工程、排队论、生存分析


证明指数分布的无记忆性

对 u≥0u\ge0 积分密度,得 P(X>u)=e−λuP(X>u)=e^{-\lambda u}。当 s,t≥0s,t\ge0 时,事件 X>s+tX>s+t 包含于 X>sX>s,后者概率为正,因此

P(X>s+t∣X>s)=e−λ(s+t)e−λs=e−λt=P(X>t).P(X>s+t\mid X>s)=\frac{e^{-\lambda(s+t)}}{e^{-\lambda s}}=e^{-\lambda t}=P(X>t).

伽马分布(选学)

推广指数分布,建模等待时间

参数:α\alpha(形状),β\beta(率),都 >0> 0

支撑集:x∈[0,∞)x \in [0, \infty)

PDF:f(x)=βαΓ(α)xα−1e−βxf(x) = \frac{\beta^\alpha}{\Gamma(\alpha)} x^{\alpha-1} e^{-\beta x} 对于 x≥0x \geq 0

矩计算:

矩生成函数为:

MX(t)=E[etX]=∫0∞etxβαΓ(α)xα−1e−βxdx=βαΓ(α)∫0∞xα−1e−(β−t)xdx=βαΓ(α)⋅Γ(α)(β−t)α=(ββ−t)α 对于 t<β\begin{aligned} M_X(t) &= \mathbb{E}[e^{tX}] \\ &= \int_{0}^{\infty} e^{tx} \frac{\beta^\alpha}{\Gamma(\alpha)} x^{\alpha-1} e^{-\beta x} dx \\ &= \frac{\beta^\alpha}{\Gamma(\alpha)} \int_{0}^{\infty} x^{\alpha-1} e^{-(\beta-t)x} dx \\ &= \frac{\beta^\alpha}{\Gamma(\alpha)} \cdot \frac{\Gamma(\alpha)}{(\beta-t)^\alpha} \\ &= \left(\frac{\beta}{\beta-t}\right)^\alpha \text{ 对于 } t < \beta \end{aligned}

使用MGF求矩:

E[X]=MX′(0)=αβα(β−t)−α−1∣t=0=αβαβ−α−1=αβ\begin{aligned} \mathbb{E}[X] &= M_X'(0) \\ &= \alpha \beta^{\alpha} (\beta-t)^{-\alpha-1} \Big|_{t=0} \\ &= \alpha \beta^{\alpha} \beta^{-\alpha-1} \\ &= \frac{\alpha}{\beta} \end{aligned} E[X2]=MX′′(0)=α(α+1)βα(β−t)−α−2∣t=0=α(α+1)β2\begin{aligned} \mathbb{E}[X^2] &= M_X''(0) \\ &= \alpha(\alpha+1)\beta^{\alpha} (\beta-t)^{-\alpha-2} \Big|_{t=0} \\ &= \frac{\alpha(\alpha+1)}{\beta^2} \end{aligned}

因此:

V(X)=E[X2]−(E[X])2=α(α+1)β2−α2β2=αβ2\begin{aligned} \mathbb{V}(X) &= \mathbb{E}[X^2] - (\mathbb{E}[X])^2 \\ &= \frac{\alpha(\alpha+1)}{\beta^2} - \frac{\alpha^2}{\beta^2} \\ &= \frac{\alpha}{\beta^2} \end{aligned}

整数形状情形:只有 α\alpha 为正整数时,才能解释为 α\alpha 个独立指数变量之和;非整数形状不能解释成求和项的个数。

应用:贝叶斯统计、降雨建模、保险


补充定义 Γ(a)=∫0∞ua−1e−u du\Gamma(a)=\int_0^\infty u^{a-1}e^{-u}\,du,其中 a>0a>0。分部积分给出 Γ(a+1)=aΓ(a)\Gamma(a+1)=a\Gamma(a),且 Γ(1)=1\Gamma(1)=1,所以正整数 kk 满足 Γ(k)=(k−1)!\Gamma(k)=(k-1)!。代换 u=βxu=\beta x 就能验证伽马密度的积分为一。密度公式按 x>0x>0 使用;零点处的取值不影响分布。

整数形状的求和性质可用卷积归纳证明。若 kk 个指数变量的和具有密度 βkxk−1e−βx/(k−1)!\beta^kx^{k-1}e^{-\beta x}/(k-1)!,再与一个指数密度卷积,就有

∫0xβkuk−1e−βu(k−1)!βe−β(x−u) du=βk+1xke−βxk!.\int_0^x\frac{\beta^ku^{k-1}e^{-\beta u}}{(k-1)!}\beta e^{-\beta(x-u)}\,du =\frac{\beta^{k+1}x^ke^{-\beta x}}{k!}.

基例正是指数密度本身。

逻辑分布(选学)

建模增长曲线和二元选择模型

参数:μ\mu(位置),ss(尺度),其中 s>0s > 0

支撑集:x∈(−∞,∞)x \in (-\infty, \infty)

PDF:f(x)=e−(x−μ)/ss(1+e−(x−μ)/s)2f(x) = \frac{e^{-(x-\mu)/s}}{s(1+e^{-(x-\mu)/s})^2}

矩计算:

累积分布函数为:

F(x)=11+e−(x−μ)/sF(x) = \frac{1}{1+e^{-(x-\mu)/s}}

对于标准逻辑分布,其中 μ=0\mu = 0 且 s=1s = 1:

f(x)=e−x(1+e−x)2f(x) = \frac{e^{-x}}{(1+e^{-x})^2}

期望值可以使用对称性求得:

E[X]=∫−∞∞x⋅e−x(1+e−x)2dx\begin{aligned} \mathbb{E}[X] &= \int_{-\infty}^{\infty} x \cdot \frac{e^{-x}}{(1+e^{-x})^2} dx \end{aligned}

令 u=−xu = -x,则:

E[X]=∫∞−∞(−u)⋅eu(1+eu)2(−du)=∫−∞∞(−u)⋅eu(1+eu)2du\begin{aligned} \mathbb{E}[X] &= \int_{\infty}^{-\infty} (-u) \cdot \frac{e^{u}}{(1+e^{u})^2} (-du) \\ &= \int_{-\infty}^{\infty} (-u) \cdot \frac{e^{u}}{(1+e^{u})^2} du \end{aligned}

使用恒等式 eu(1+eu)2=e−u(1+e−u)2\frac{e^{u}}{(1+e^{u})^2} = \frac{e^{-u}}{(1+e^{-u})^2}:

E[X]=−∫−∞∞u⋅e−u(1+e−u)2du=−E[X]\begin{aligned} \mathbb{E}[X] &= -\int_{-\infty}^{\infty} u \cdot \frac{e^{-u}}{(1+e^{-u})^2} du \\ &= -\mathbb{E}[X] \end{aligned}

因此,E[X]=0\mathbb{E}[X] = 0。

对于方差:

E[X2]=∫−∞∞x2⋅e−x(1+e−x)2dx\begin{aligned} \mathbb{E}[X^2] &= \int_{-\infty}^{\infty} x^2 \cdot \frac{e^{-x}}{(1+e^{-x})^2} dx \end{aligned}

使用替换 u=11+e−xu = \frac{1}{1+e^{-x}},这给出 x=ln⁡(u1−u)x = \ln\left(\frac{u}{1-u}\right) 和 dx=duu(1−u)dx = \frac{du}{u(1-u)}:

E[X2]=∫01[ln⁡(u1−u)]2du\begin{aligned} \mathbb{E}[X^2] &= \int_{0}^{1} \left[\ln\left(\frac{u}{1-u}\right)\right]^2 du \end{aligned}
证明逻辑分布二阶矩的积分计算

对 x≥0x\ge0,标准逻辑分布的密度不超过 e−xe^{-x},所以一阶、二阶绝对矩都有限,前面的对称性论证成立。分部积分给出 ∫01log⁡2u du=2\int_0^1\log^2u\,du=2。展开 −log⁡(1−u)=∑n≥1un/n-\log(1-u)=\sum_{n\ge1}u^n/n,再对非负项使用单调收敛定理,得到

∫01log⁡ulog⁡(1−u) du=∑n≥11n(n+1)2=∑n≥1(1n−1n+1−1(n+1)2)=2−∑n≥11n2.\begin{aligned} \int_0^1\log u\log(1-u)\,du &=\sum_{n\ge1}\frac{1}{n(n+1)^2}\\ &=\sum_{n\ge1}\left(\frac1n-\frac1{n+1}-\frac1{(n+1)^2}\right) =2-\sum_{n\ge1}\frac1{n^2}. \end{aligned}

其中 ∫01(−log⁡u)un du=1/(n+1)2\int_0^1(-\log u)u^n\,du=1/(n+1)^2 也由分部积分得到。将 log⁡u−log⁡(1−u)\log u-\log(1-u) 的平方展开,即得

∫01log⁡2u1−u du=2∑n≥11n2=π23.\int_0^1\log^2\frac{u}{1-u}\,du=2\sum_{n\ge1}\frac1{n^2}=\frac{\pi^2}{3}.

最后一步使用 Basel 恒等式 ∑n−2=π2/6\sum n^{-2}=\pi^2/6。本系列尚未证明这条恒等式:上面的积分归约已经完成,但级数的精确求值仍是一项明确的分析前置依赖。

对于一般逻辑分布 X=μ+sZX = \mu + sZ,其中 Z∼逻辑(0,1)Z \sim \text{逻辑}(0,1):

E[X]=μ+sE[Z]=μ\begin{aligned} \mathbb{E}[X] &= \mu + s\mathbb{E}[Z] \\ &= \mu \end{aligned} V(X)=s2V(Z)=s2π23\begin{aligned} \mathbb{V}(X) &= s^2\mathbb{V}(Z) \\ &= \frac{s^2\pi^2}{3} \end{aligned}

Gumbel 变量之差。 设 G1,G2G_1,G_2 独立,具有相同位置参数 μ\mu 和尺度参数 s>0s>0,CDF 为 exp⁡(−e−(x−μ)/s)\exp(-e^{-(x-\mu)/s})。令 Ei=e−(Gi−μ)/sE_i=e^{-(G_i-\mu)/s},直接代入可得 P(Ei>t)=e−tP(E_i>t)=e^{-t}(t>0t>0),所以二者是独立的单位参数指数变量。因此

P(G1−G2≤z)=P(E2≤ez/sE1)=∫0∞(1−e−ez/st)e−t dt=11+e−z/s.\begin{aligned} P(G_1-G_2\le z) &=P(E_2\le e^{z/s}E_1)\\ &=\int_0^\infty(1-e^{-e^{z/s}t})e^{-t}\,dt =\frac1{1+e^{-z/s}}. \end{aligned}

这就是 Logistic(0,s)(0,s) 的 CDF。若位置参数不同,差值的位置参数变为 μ1−μ2\mu_1-\mu_2;独立性和相同尺度是这里必需的条件。

应用:逻辑回归、选择建模、增长曲线


更多关于随机变量及其性质的详细信息,请参见随机变量。

关于期望和方差计算,请参见期望和方差。

练习

练习基于指示变量推导二项分布的矩

设随机变量 X∼Binomial(n,p)X \sim \text{Binomial}(n, p)。利用将 XX 表示为独立同分布的伯努利随机变量之和的方法,推导期望 E[X]\mathbb{E}[X] 与方差 V(X)\mathbb{V}(X) 的计算公式。

解

将二项随机变量 XX 表示为 nn 个相互独立的指示随机变量之和:

X=∑i=1nIiX = \sum_{i=1}^n I_i

其中每个 Ii∼Bernoulli(p)I_i \sim \text{Bernoulli}(p),取值概率为:

P(Ii=1)=p,P(Ii=0)=1−p.P(I_i = 1) = p, \quad P(I_i = 0) = 1 - p.
  1. 单个指示变量 IiI_i 的期望:
E[Ii]=1⋅p+0⋅(1−p)=p.\mathbb{E}[I_i] = 1 \cdot p + 0 \cdot (1 - p) = p.

利用期望的线性性质:

E[X]=E[∑i=1nIi]=∑i=1nE[Ii]=∑i=1np=np.\mathbb{E}[X] = \mathbb{E}\left[\sum_{i=1}^n I_i\right] = \sum_{i=1}^n \mathbb{E}[I_i] = \sum_{i=1}^n p = np.
  1. 单个指示变量 IiI_i 的方差:
E[Ii2]=12⋅p+02⋅(1−p)=p.\mathbb{E}[I_i^2] = 1^2 \cdot p + 0^2 \cdot (1 - p) = p.V(Ii)=E[Ii2]−(E[Ii])2=p−p2=p(1−p).\mathbb{V}(I_i) = \mathbb{E}[I_i^2] - (\mathbb{E}[I_i])^2 = p - p^2 = p(1 - p).

由于各次试验 I1,I2,…,InI_1, I_2, \dots, I_n 相互独立,方差具有完全可加性:

V(X)=V(∑i=1nIi)=∑i=1nV(Ii)=∑i=1np(1−p)=np(1−p).\mathbb{V}(X) = \mathbb{V}\left(\sum_{i=1}^n I_i\right) = \sum_{i=1}^n \mathbb{V}(I_i) = \sum_{i=1}^n p(1 - p) = np(1 - p).
练习二项分布概率质量函数的递推关系
  1. 证明对于 X∼Binomial(n,p)X \sim \text{Binomial}(n, p),其概率质量函数对任意 k∈{0,1,…,n−1}k \in \{0, 1, \dots, n-1\} 满足以下递推关系式:
P(X=k+1)=p1−p⋅n−kk+1⋅P(X=k).P(X = k+1) = \frac{p}{1-p} \cdot \frac{n-k}{k+1} \cdot P(X = k).
  1. 确定该递推关系的初始基准项(Base Case)。
  2. 阐明在计算机程序中使用该递推公式生成概率分布表相比直接计算阶乘的算法优势。
解
  1. 递推比值的推导: 由二项分布 PMF 的定义公式:
P(X=k)=n!k!(n−k)!pk(1−p)n−k,P(X = k) = \frac{n!}{k!(n-k)!} p^k (1-p)^{n-k},P(X=k+1)=n!(k+1)!(n−k−1)!pk+1(1−p)n−k−1.P(X = k+1) = \frac{n!}{(k+1)!(n-k-1)!} p^{k+1} (1-p)^{n-k-1}.

计算相邻两项的商:

P(X=k+1)P(X=k)=n!(k+1)!(n−k−1)!pk+1(1−p)n−k−1n!k!(n−k)!pk(1−p)n−k=k!(n−k)!(k+1)!(n−k−1)!⋅pk+1(1−p)n−k−1pk(1−p)n−k.\frac{P(X = k+1)}{P(X = k)} = \frac{\frac{n!}{(k+1)!(n-k-1)!} p^{k+1} (1-p)^{n-k-1}}{\frac{n!}{k!(n-k)!} p^k (1-p)^{n-k}} = \frac{k!(n-k)!}{(k+1)!(n-k-1)!} \cdot \frac{p^{k+1}(1-p)^{n-k-1}}{p^k(1-p)^{n-k}}.

化简阶乘与幂次因子:

k!(k+1)!=1k+1,(n−k)!(n−k−1)!=n−k,pk+1(1−p)n−k−1pk(1−p)n−k=p1−p.\frac{k!}{(k+1)!} = \frac{1}{k+1}, \qquad \frac{(n-k)!}{(n-k-1)!} = n - k, \qquad \frac{p^{k+1}(1-p)^{n-k-1}}{p^k(1-p)^{n-k}} = \frac{p}{1-p}.

整理即得递推关系式:

P(X=k+1)=p1−p⋅n−kk+1⋅P(X=k).P(X = k+1) = \frac{p}{1-p} \cdot \frac{n-k}{k+1} \cdot P(X = k).
  1. 初始基准项: 递推从 k=0k=0 开始,对应 0 次成功的概率:
P(X=0)=(1−p)n.P(X = 0) = (1 - p)^n.
  1. 算法与数值计算优势: 直接计算组合数 (nk)=n!k!(n−k)!\binom{n}{k} = \frac{n!}{k!(n-k)!} 需要计算极大整数的阶乘,当 nn 稍大时(例如在 64 位 IEEE 754 浮点数下 n>170n > 170)阶乘会迅速发生数值溢出(Floating-point Overflow)。通过递推公式,计算每个后续概率 P(X=k+1)P(X=k+1) 仅需常数次浮点乘除法,不仅能在 O(n)O(n) 时间内顺序求出全部分布值,也避免了阶乘溢出,但不能保证数值稳定:起始值 (1−p)n(1-p)^n 可能下溢,舍入误差也可能累积。比值推导要求 0<p<10<p<1;p=0,1p=0,1 时单独按点质量处理。